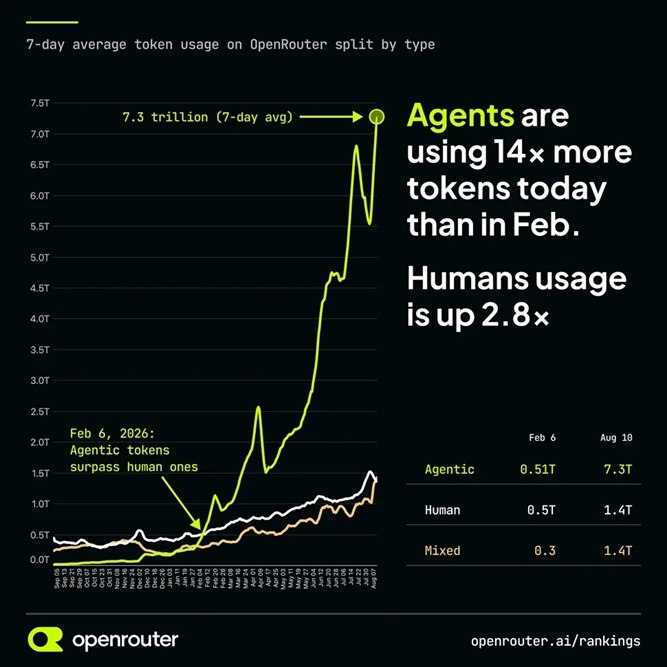
عاملهای هوش مصنوعی حالا بیشتر از خود کاربران انسانی از مدلهای هوش مصنوعی استفاده میکنند. دادههای OpenRouter نشان میدهد این عاملها در ماه اوت حدود ۷.۳ تریلیون توکن مصرف کردهاند؛ رقمی که بیش از پنج برابر ۱.۴ تریلیون توکن مصرفشده توسط کاربران انسانی است.
اگر تا به امروز فکر میکردید که هوش مصنوعی ساخته شده تا انسانها اولین استفادهکنندگان از آن باشند، شاید باید در برداشت خود از ماهیت اینروزها دنیای AI تجدید نظر کنید. جدیدترین گزارشهای تخصصی نشان داده که مصرفکننده ظرفیت پردازشی مدلهای هوش مصنوعی معروف، بیشتر خود عاملهای هوش مصنوعی هستند تا انسانها!
نکته بسیار ویژه در خصوص این عدم تقارن آن است که این فاصله در حال بیشتر شدن نیز است. مصرف توکن عاملها از ماههای فوریه تا اوت سال جاری میلادی (طی 7 ماه) حدود ۱۴ برابر رشد کرده، در حالی که مصرف کاربران انسانی در همین مدت ۲.۸ برابر شده است.
دنیل نیومن، مدیرعامل گروه Futurum، با توجه به همین روند پستی را در حساب X خود منتظر کرده که میگوید، نسبت فعلی میتواند در آینده به ۱۰ برابر برسد و حتی از آن هم عبور کند.
چرا عاملها بیشتر از انسان توکن مصرف میکنند؟
از دید فنی تفاوت ساختاری نحوه استفاده انسان و عامل از ابزاری به کارآمدی هوش مصنوعی، دلیل اصلی اختلاف در میزان استفاده است. کاربر معمولاً سؤالش را مطرح میکند و پاسخ میگیرد، اما عامل برای انجام کاری مثل نوشتن کد یا بررسی یک پروژه ممکن است بارها با مدل ارتباط برقرار کند. عامل نتیجه یک مرحله را میگیرد، آن را بررسی میکند، ابزار دیگری را به کار میگیرد و دوباره سراغ مدل میرود.
در این رفتوبرگشتها، سابقه کار هم مرتب همراه درخواستهای جدید قرار میگیرد و تعداد توکنها خیلی سریع بالا میرود. به همین دلیل، مصرف بیشتر توکن لزوماً به معنی انجام پنج برابر کار بیشتر نیست؛ بخشی از این مصرف حاصل همان رفتوبرگشتهای متعدد و حمل دوباره اطلاعات قبلی است.
مسئله عجیب عاملها و توکنها تکراری
دادههای OpenRouter نشان میدهد بیش از ۸۵ درصد توکنهای ورودی عاملها از Promptهای کششده تشکیل شدهاند؛ یعنی بخشهایی از ورودی که قبلاً استفاده شدهاند و سیستم میتواند برای کاهش زمان و هزینه پردازش، از نسخه ذخیرهشده آنها استفاده کند.
اما اگر با ساختار رسیدن به پاسخ در مدلهای هوش مصنوعی آشنا باشید باید در نظر بگیرید که این موضوع را نباید با KV Cache یکی دانست. Prompt Caching برای استفاده مجدد از بخشهای تکراری ورودی است، در حالی که KV Cache اطلاعات میانی حاصل از پردازش توکنها را برای ادامه همان فرایند نگه میدارد. هر دو به اجرای سریعتر مدل کمک میکنند، اما سازوکارشان متفاوت است.
همین حجم بالای اطلاعات تکراری، مسئله حافظه را جدیتر میکند. یک عامل که ساعتها روی یک کار باقی میماند، باید سابقه بیشتری را در طول فرایند در دسترس نگه دارد و این یعنی فشار بیشتر روی حافظه و پهنایباند سیستم.
فشار عاملها به HBM هم میرسد
این بخش برای سازندگان سختافزار اهمیت زیادی دارد. شتابدهندههای دیتاسنتری هوش مصنوعی از HBM، حافظهای بسیار سریع و پرپهنایباند، برای نگهداری و دسترسی سریع به دادههای مورد نیاز مدلها استفاده میکنند.
شرکت تحقیقاتی اندریسن هورویتز با استناد به دادههای OpenRouter اعلام کرده رشد KV Cache میتواند از ظرفیت حافظه HBM موجود در شتابدهندههای فعلی فراتر برود. به این ترتیب، افزایش بار کاری عاملها فقط به GPUهای بیشتر نیاز ندارد؛ ظرفیت حافظه و سرعت انتقال داده نیز باید همزمان افزایش پیدا کند.
۹۶ درصد ورودیهای عاملها تکراری است!
نکته جالب توجه دیگر در این زمینه، انبوه ورودیهای تکراری توسط عاملهای هوش مصنوعی است که نمونهای از این رفتار در استفاده از عاملهای برنامهنویسی دیده شده است. یک شرکت فعال در حوزه مشاوره مراکز تماس که عاملهای خود را با مدل DeepSeek روی سرورهای مجهز به NVIDIA H200 آزمایش کرده، گزارش داده که حدود ۹۶ درصد ورودیهای Claude Code در ماه سپتامبر مربوط به مکالمات و اطلاعات قبلی بوده است.
برای یک عامل، این رفتار طبیعی است. اگر قرار باشد پروژهای را در چند مرحله پیش ببرد، باید بداند قبلاً چه فایلهایی را بررسی کرده، چه تصمیمهایی گرفته شده و نتیجه مراحل قبلی چه بوده است. بنابراین بخشی از همان اطلاعات دوباره در اختیار مدل قرار میگیرد، حتی اگر داده تازهای به آن اضافه نشده باشد.
مسئله فقط GPU بیشتر نیست
رشد عاملهای هوش مصنوعی میتواند معادله سختافزار این صنعت را هم تغییر دهد. عاملهای بیشتر یعنی درخواستهای بیشتر، اما در کنار آن حافظه بیشتر برای نگهداری زمینه کار و پهنایباند بالاتر برای جابهجایی این دادهها هم لازم خواهد بود.
بازار HBM همین حالا به دلیل تقاضای مراکز داده هوش مصنوعی تحت فشار است و گسترش عاملها میتواند این فشار را بیشتر کند. بنابراین اگر پیشبینی دنیل نیومن درباره رشد چندبرابری مصرف عاملها محقق شود، رقابت سختافزاری AI فقط بر سر ساخت GPUهای قدرتمندتر نخواهد بود؛ حافظه سریع و پرظرفیت هم به همان اندازه مهم خواهد شد.
البته رسیدن مصرف عاملها به ۱۰ برابر یا حتی ۲۰ و ۳۰ برابر انسان هنوز یک پیشبینی است و دادههای OpenRouter به تنهایی نمیتواند رفتار کل صنعت را نشان دهد. اما روند فعلی روشن است: عاملهای هوش مصنوعی با سرعت زیادی در حال تبدیل شدن به مصرفکنندگان اصلی زیرساخت AI هستند و هرچه کارهای طولانیتر و پیچیدهتری به آنها سپرده شود، نیاز به حافظه و انتقال سریع داده نیز بیشتر خواهد شد.





نظر خود را اضافه کنید.
برای ارسال نظر وارد شوید
ارسال نظر بدون عضویت در سایت