مایکروسافت نسخه جدید مدل هوش مصنوعی خود با نام MAI-Code-1.1-Flash را برای اجرای آفلاین منتشر کرده که برای اجرای روان آن باید کامپیوتر بسیار قدرتمندی داشته باشید و بیش از 120 گیگابایت حافظه رم روی سیستمتان نصب باشد.
نسخه آفلاین MAI-Code-1.1-Flash با استفاده از کوانتیزاسیون 3 بیتی بهینه شده تا مصرف حافظه کاهش پیدا کند. با وجود این فشردهسازی، پنجره زمینه کامل 256 هزار توکن در مدل حفظ شده است.
مایکروسافت همچنین میگوید نسخه کوانتایزشده از نظر عملکرد کدنویسی تفاوت قابلتوجهی با نسخه با دقت کامل ندارد و در بنچمارکهای SWE-Bench Verified و Terminal-Bench 2.1 عملکردی قابلمقایسه دارد.
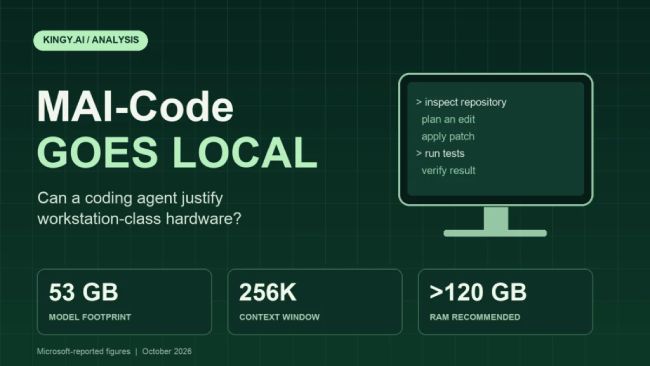
با اجرای محلی این مدل، GitHub Copilot میتواند برخی وظایف کدنویسی سازگار را مستقیماً روی کامپیوتر کاربر انجام دهد. مایکروسافت در جریان معرفی این قابلیت، اجرای MAI-Code-1.1-Flash را در حالت Airplane Mode نیز به نمایش گذاشت تا نشان دهد برای پردازشهای محلی، اتصال فعال اینترنت ضروری نیست.
البته در صورت نیاز به توان پردازشی بیشتر، همچنان میتوان از مدلهای ابری استفاده کرد. نیاز MAI-Code-1.1-Flash به بیش از 120 گیگابایت حافظه رم باعث میشود اجرای آن روی بیشتر کامپیوترهای معمولی عملاً گزینه مناسبی نباشد. MAI-Code-1.1-Flash نسبت به مدلی که مایکروسافت در رویداد Build معرفی کرده بود، بهینهتر شده است.
بر اساس گزارش neowin این مدل اکنون در محیط عملیاتی GitHub Copilot قرار دارد و به گفته مایکروسافت، بازخورد توسعهدهندگان باعث تمرکز بهینهسازیها روی وظایف CLI و .NET شده است. این تغییرات به ترتیب به 22 درصد بهبود در ابزار ترمینال و 15 درصد افزایش عملکرد در پردازشهای .NET منجر شدهاند.
مایکروسافت همچنین اعلام کرده سرعت استریم توکنها نسبت به MAI-Code-1.0 حدود 25 درصد بیشتر شده و مدل برای تکمیل هر وظیفه به 25 درصد توکن کمتر نیاز دارد. مجموع این بهینهسازیها هزینه آموزش و سرویسدهی MAI-Code-1.1-Flash را به حدود یکچهارم نسل اولیه رسانده است.
نسخه محلی MAI-Code-1.1-Flash هماکنون برای دانلود در دسترس توسعهدهندگان قرار دارد و دسترسی آزمایشی آن نیز تا پایان ماه در اپلیکیشن GitHub Copilot، GitHub Copilot CLI و Visual Studio Code فعال خواهد شد.





نظر خود را اضافه کنید.
برای ارسال نظر وارد شوید
ارسال نظر بدون عضویت در سایت