خرید کامپیوتر برای اجرای محلی هوش مصنوعی (Local AI) با خرید یک سیستم معمولی برای گیمینگ، رندرینگ یا تدوین ویدیو تفاوت دارد. در یک سیستم گیمینگ، قدرت پردازشی کارت گرافیک و نرخ فریم معمولاً مهمترین فاکتورها هستند، اما در دنیای هوش مصنوعی لوکال معادله تا حد زیادی تغییر میکند. اینجا ممکن است یک کارت گرافیک نسل قبل با حافظه بیشتر، برای اجرای مدلهای هوش مصنوعی انتخاب بهتری از یک کارت جدیدتر و گرانقیمت با VRAM محدود باشد.
تنوع مدلهای زبانی بزرگ (LLM) مانند Llama ،Qwen و DeepSeek، ابزارهای تولید تصویر مانند Stable Diffusion و FLUX و همچنین کاربردهایی مثل راهاندازی سیستمهای تحلیل اسناد (RAG)، باعث شده نیاز سختافزاری کاربران برای اجرای Local AI یکسان نباشد. در این راهنمای خرید، ابتدا مفاهیم پایه و نقش قطعات مختلف را بررسی میکنیم و سراغ گلوگاههای سختافزاری میرویم تا بدانید برای اجرای هوش مصنوعی بهصورت محلی، چه سختافزاری واقعاً اهمیت دارد.
فهرست مطالب این مقاله:
- مقدمه: Local AI چیست و چرا به سیستم اختصاصی نیاز داریم؟
- VRAM؛ مهمترین فاکتور در اجرای هوش مصنوعی لوکال
- نقش RAM در اجرای مدلهای هوش مصنوعی
- پردازنده مرکزی (CPU) مناسب برای Local AI
- NVIDIA ،AMD یا Apple Silicon؛ کدام سختافزار برای Local AI بهتر است؟
- Quantization چیست و چرا اهمیت دارد؟
- بهترین سیستمهای پیشنهادی برای Local AI در بازار ایران
- جمعبندی
- پرسشهای متداول
مقدمه: Local AI چیست و چرا به سیستم اختصاصی نیاز داریم؟
اجرای محلی هوش مصنوعی یا Local AI به این معناست که مدلهای هوش مصنوعی بهجای اجرا روی سرورهای ابری، روی سختافزار شخصی کاربر بارگذاری و اجرا شوند. حفظ حریم خصوصی و کنترل بیشتر روی دادهها، حذف هزینه اشتراک سرویسهای ابری، امکان استفاده بدون وابستگی دائمی به اینترنت و قابلیت شخصیسازی بیشتر، از مهمترین دلایلی هستند که کاربران را به سمت هوش مصنوعی لوکال سوق میدهند.
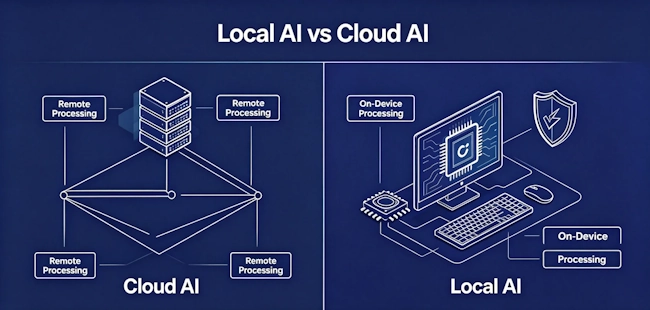
امروزه به لطف ابزارهای متنباز و رابطهای کاربری سادهای مانند Ollama ،LM Studio و llama.cpp، اجرای مدلهای زبانی روی کامپیوتر شخصی بسیار سادهتر از گذشته شده است. البته Local AI فقط به مدلهای متنی محدود نمیشود و میتوان مدلهای تولید تصویر را در محیطهایی مانند ComfyUI اجرا کرد یا برای پردازش صوت از ابزارهایی مانند Whisper کمک گرفت.
اما با وجود سادهتر شدن نرمافزارها، یک سؤال مهم همچنان باقی است: برای اجرای هوش مصنوعی به چه سختافزاری نیاز داریم؟
VRAM؛ مهمترین فاکتور در اجرای هوش مصنوعی لوکال
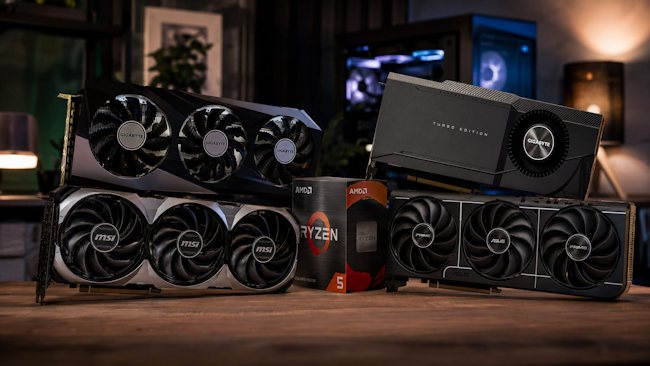
اگر قرار باشد تنها یک قطعه را بهعنوان مهمترین بخش سیستم مناسب Local AI انتخاب کنیم، بدون شک کارت گرافیک و بهویژه ظرفیت VRAM در صدر قرار میگیرد.
اجرای مدلهای زبانی بزرگ (LLM Inference) تا حد زیادی به ظرفیت و پهنای باند حافظه گرافیکی وابسته است و بسیاری از این پردازشها ماهیت Memory-Bound دارند. وزنهای مدل باید تا حد امکان در حافظه سریع GPU قرار بگیرند تا پردازنده گرافیکی بتواند آنها را با سرعت بالا پردازش کند. علاوه بر خود مدل، بخشی از VRAM نیز برای مواردی مانند KV Cache و Context Length مورد نیاز است؛ بنابراین هرچه Context Length را بالاتر ببرید، مثلاً تا 32K یا 128K، میزان حافظه مورد نیاز نیز میتواند به شکل محسوسی افزایش پیدا کند.
بهطور کلی میتوان ظرفیت VRAM را اینگونه در نظر گرفت:
- ۸ گیگابایت VRAM: برای شروع کار، آزمایش مدلهای سبک 7B یا 8B کوانتایزشده و برخی کاربردهای ساده تولید تصویر مناسب است.
- ۱۲ تا ۱۶ گیگابایت VRAM: نقطه شروع مناسب برای اجرای مدلهای 7B/8B با Context بالاتر، مدلهای 14B کوانتایزشده و مدلهای تولید تصویر مانند Stable Diffusion XL و FLUX محسوب میشود.
- ۲۴ تا ۳۲ گیگابایت VRAM و بیشتر: برای اجرای مدلهای بزرگتر مانند 32B، Contextهای سنگین، RAGهای پیشرفته و در برخی موارد استفاده از چند GPU برای مدلهای بسیار بزرگ مانند DeepSeek-R1 یا Llama 70B مناسبتر است.
البته این اعداد را نباید بهعنوان یک قانون ثابت در نظر گرفت؛ نوع مدل، روش Quantization، اندازه Context و نرمافزار مورد استفاده همگی روی میزان حافظه مورد نیاز تأثیر دارند.
نقش RAM در اجرای هوش مصنوعی
RAM سیستم جایگزین مستقیم VRAM نیست، اما در یک سیستم Local AI همچنان نقش مهمی دارد. نخست اینکه اگر مدل مورد نظر بزرگتر از ظرفیت VRAM کارت گرافیک باشد، ابزارهایی مانند Ollama یا LM Studio میتوانند بخشی از مدل را در VRAM و بخش باقیمانده را در RAM قرار دهند؛ روشی که با عنوان GPU Offloading شناخته میشود. البته در این حالت، به دلیل سرعت بسیار پایینتر RAM نسبت به VRAM، عملکرد و سرعت تولید توکن میتواند به شکل محسوسی کاهش پیدا کند.
RAM بیشتر در کاربردهایی مانند RAG و پردازش حجم زیادی از اسناد نیز اهمیت پیدا میکند. بنابراین برای یک سیستم امروزی، پیشنهاد کلی را میتوان اینگونه در نظر گرفت:
- ۳۲ گیگابایت RAM: حداقل ظرفیت منطقی برای یک سیستم عمومی اجرای هوش مصنوعی.
- ۶۴ تا ۱۲۸ گیگابایت RAM: انتخاب مناسبتر برای سیستمهای نیمهحرفهای، اجرای مدلهای بزرگتر با GPU Offloading و پروژههای سنگینتر RAG.
پردازنده مرکزی (CPU)
برخلاف GPU، پردازنده مرکزی معمولاً موتور اصلی اجرای مدلهای سنگین هوش مصنوعی نیست، اما همچنان وظایف مهمی بر عهده دارد؛ از بارگذاری مدل و آمادهسازی دادههای ورودی گرفته تا پردازش Embedding و مدیریت جریان داده.
ر همین رابطه بخوانید:
- بهترین کارت گرافیک برای هوش مصنوعی در 2026؛ راهنمای خرید GPU برای Local AI و LLM
برای بیشتر کاربران، یک پردازنده مدرن ۶ یا ۸ هستهای از خانوادههایی مانند Ryzen 7000-9000 یا Core i5-i7 برای شروع کاملاً کافی است. با این حال، شرایط در سیستمهای حرفهای Multi-GPU متفاوت میشود. در چنین سیستمهایی تعداد خطوط PCIe، پهنای باند و توان پردازشی CPU اهمیت بیشتری پیدا میکند و پلتفرمهایی مانند Threadripper میتوانند مزیت قابلتوجهی داشته باشند.
NVIDIA ،AMD یا Apple Silicon؛ کدام سختافزار برای Local AI بهتر است؟
در حال حاضر NVIDIA به لطف اکوسیستم CUDA و پشتیبانی گسترده از Tensor Coreها، سادهترین مسیر را برای اجرای طیف وسیعی از مدلها و ابزارهای هوش مصنوعی فراهم میکند. بسیاری از کتابخانهها و فریمورکهای محبوب AI ابتدا برای CUDA بهینه میشوند و همین موضوع باعث شده کارتهای GeForce RTX 30، RTX 40 و RTX 50، از جمله RTX 5090 و RTX 5080، گزینههای کمدردسرتری برای کاربران باشند.
البته AMD نیز با پلتفرم ROCm در سالهای اخیر پیشرفت کرده است. کارتهایی مانند RX 7900 XTX با ۲۴ گیگابایت VRAM میتوانند از نظر نسبت قیمت به ظرفیت حافظه گزینههای جذابی باشند، هرچند سازگاری نرمافزاری و پشتیبانی از مدلها و ابزارهای مختلف را باید پیش از خرید بررسی کرد.
ر همین رابطه بخوانید:
- راهنمای انتخاب بهترین CPU برای Local AI
- راهنمای خرید بهترین رم برای هوش مصنوعی Local AI
در سوی دیگر، علاقهمندان به اکوسیستم اپل میتوانند سراغ تراشههای Apple Silicon مانند M2 ،M3 و M4 در نسخههای Pro ،Max و Ultra بروند. مزیت اصلی این تراشهها استفاده از Unified Memory یا حافظه یکپارچه است که باعث میشود CPU و GPU به یک فضای حافظه مشترک دسترسی داشته باشند. در نتیجه، سیستمهای مجهز به حافظه یکپارچه با ظرفیت بالا میتوانند برای اجرای مدلهای بزرگ، بهخصوص در سناریوهایی که ظرفیت حافظه اهمیت بیشتری از قدرت خام GPU دارد، گزینه قابلتوجهی باشند.
Quantization چیست و چرا اهمیت دارد؟
مدلهای هوش مصنوعی در حالت اصلی معمولاً با دقتهایی مانند FP16 حجم قابلتوجهی دارند و اجرای آنها به حافظه زیادی نیاز دارد. Quantization یا کوانتایزیشن روشی برای کاهش دقت عددی وزنهای مدل است؛ برای مثال میتوان وزنها را از ۱۶ بیت به ۸، ۵ یا ۴ بیت کاهش داد تا حجم مدل و حافظه مورد نیاز آن کمتر شود.
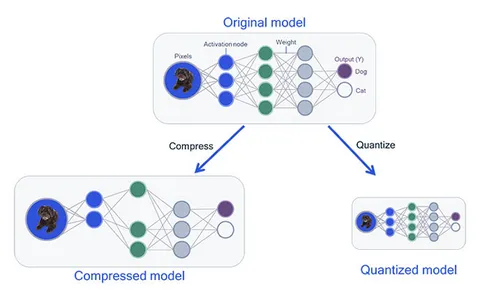
فرمتهایی مانند GGUF اجرای مدلهای کوانتایزشده را روی کامپیوترهای شخصی سادهتر کردهاند. برای مثال، یک مدل ۱۴ میلیارد پارامتری در حالت FP16 حدود ۲۸ گیگابایت حافظه برای وزنهای خود نیاز دارد، در حالی که نسخه ۴ بیتی مانند Q4_K_M میتواند به حدود ۹ گیگابایت حافظه نیاز داشته باشد.
البته Quantization کاملاً بدون هزینه نیست و بسته به مدل، روش کوانتایزیشن و میزان کاهش دقت، ممکن است مقداری از کیفیت یا دقت خروجی کاهش پیدا کند. با این حال، همین تکنیک یکی از مهمترین دلایلی است که اجرای مدلهای نسبتاً بزرگ روی کامپیوترهای شخصی را امکانپذیر کرده است.
بهترین سیستمهای پیشنهادی برای Local AI در بازار ایران
حالا که با مهمترین متغیرهای سختافزاری آشنا شدیم، در ادامه سراغ ۱۰ کانفیگ پیشنهادی برای اجرای Local AI میرویم. این سیستمها از گزینههای اقتصادی برای شروع کار با مدلهای 7B گرفته تا سیستمهای حرفهای Multi-GPU را پوشش میدهند تا بتوانید متناسب با بودجه و نوع استفاده، انتخاب دقیقتری داشته باشید.
سیستم پیشنهادی شماره 1
سیستم اقتصادی برای شروع Local AI
ارزانترین سیستم پیشنهادی با 16 گیگابایت VRAM
حدود 500 میلیون تومان
| قطعه | مدل | قیمت |
|---|---|---|
| مادربرد | ASUS PRIME B850M-F WIFI DDR5 | 32 |
| پردازنده | AMD Ryzen 5 9600X | 45 |
| رم | Crucial (2x16GB) 32GB 5600MHz | 120 |
| کارت گرافیک | ASUS Dual RTX 5060 Ti 16GB OC Edition | 236 |
| هارد دیسک | اختیاری | - |
| کیس | AWEST GT-AV12-BG | 14 |
| خنک کننده | DeepCool AG500 | 11 |
| پاور | Cooler Master MWE 700 Bronze | 17.5 |
| اس اس دی M.2 | Sandisk Extreme 1TB PCIe 4.0 | 31.5 |
بهترین سیستم پیشنهادی برای:
- شروع Local AI و اجرای چتباتهای محلی با ابزارهایی مثل Ollama و LM Studio
- اجرای روان مدلهای زبانی 7B و 8B (مانند Llama 3 و Qwen 2.5) و تست مدلهای 14B کوانتایزشده
- تولید تصویر ابتدایی در Stable Diffusion و اجرای دستیار کدنویسی
اگر هدف شما ورود به دنیای هوش مصنوعی لوکال است و بودجه محدودی دارید، این سیستم نسبتاً ارزان را برای شروع پیشنهاد میکنیم. نقطه عطف این کانفیگ، کارت گرافیک 16 گیگابایتی (RTX 5060 Ti یا RTX 4060 Ti) است. توجه داشته باشید که نسخه 8 گیگابایتی همین کارتها برای پردازش هوش مصنوعی اصلاً توصیه نمیشود، چرا که ظرفیت VRAM گلوگاه اصلی بارگذاری مدلها است.
وجود 16 گیگابایت VRAM به شما اجازه میدهد مدلهای ۸ میلیارد پارامتری را بدون کوانتایز شدید (با دقت Q8 یا حتی FP16) و مدلهای ۱۴ میلیارد پارامتری را با دقت Q4_K_M بهطور کامل روی حافظه گرافیکی اجرا کنید. هستههای Tensor انویدیا و اکوسیستم CUDA در این رده قیمتی سرعت تولید توکن متنی معادل ۳۰ تا ۵۰ توکن بر ثانیه ارائه میدهند که فراتر از سرعت خواندن انسان است.
پردازنده 6 هستهای Ryzen 5 9600X در ترکیب با 32 گیگابایت رم DDR5 سرعت بالایی در بارگذاری مدلها ارائه میدهد و برای سناریوهای غیرحرفهای کم نمیآورد.
سیستم پیشنهادی شماره 2
بهترین سیستم متعادل برای Local AI
ارزش خرید بسیار بالا (Best Value) با حافظه GDDR7
حدود 700 میلیون تومان
| قطعه | مدل | قیمت |
|---|---|---|
| مادربرد | ASUS PRIME B850 M-K | 35 |
| پردازنده | AMD Ryzen 7 9700X | 62 |
| رم | Crucial (2x16GB) 32GB 5600MHz | 120 |
| کارت گرافیک | MSI RTX 5070 Ti 16GB SHADOW 3X OC | 395 |
| هارد دیسک | اختیاری | - |
| کیس | MSI MAG FORGE 120A AIRFLOW | 12.5 |
| خنک کننده | DeepCool AG620 | 11.5 |
| پاور | XPG KYBER 850W | 19.5 |
| اس اس دی M.2 | WD Blue SN5000 2TB PCIe 4.0 | 61 |
بهترین سیستم پیشنهادی برای:
- اجرای روان مدلهای 7B تا 14B با پاسخدهی سریع و سرعت توکن بالا
- کار با مدلهای 32B (کوانتایز Q4)، سیستمهای RAG سبک و پردازش اسناد متنی
- تولید تصویر حرفهای با SDXL و مدلهای خانواده FLUX.1
این کانفیگ طلاییترین «نسبت کارایی به قیمت» را در میان سیستمهای هوش مصنوعی پیشنهادی ما داراست. کارت گرافیک RTX 5070 Ti با بهرهگیری از حافظه نسل جدید GDDR7، پهنای باند بهمراتب بیشتری نسبت به نسل قبل ارائه میدهد که مستقیماً باعث افزایش نرخ تولید توکن در ثانیه میشود.
وجود 32 گیگابایت رم DDR5 نیز به شما این امکان را میدهد که علاوه بر لود کامل مدلهای ۱۶ گیگابایتی روی VRAM، سناریوهای ترکیبی Offloading را برای تست مدلهای بزرگتر (مانند نسخه کوانتایزشده Llama 3.1 70B با فرمت IQ3) به اجرا درآورید. همچنین اساسدی ۲ ترابایتی پرسرعت، فضای کافی برای ذخیرهسازی دهها چکپوینت و دیتابیس برداری را بدون دغدغه کمبود فضا فراهم میکند.
پردازنده ۸ هستهای Ryzen 7 9700X انتخابی برای این سیستم پردازش پیشنیازها و مدیریت جابهجایی دادهها را بدون کوچکترین گلوگاهی انجام میدهد.
سیستم پیشنهادی شماره 3
سیستم تخصصی برنامهنویسی با AI و RAG
قدرت پردازشی بالا برای تحلیل کد و دیتابیس برداری
حدود 850 میلیون تومان
| قطعه | مدل | قیمت |
|---|---|---|
| مادربرد | ASUS PRIME X870-P Wi-Fi | 53 |
| پردازنده | AMD Ryzen 9 9900X | 99 |
| رم | G.SKILL Ripjaws S5 32GB (2x16GB) 6000MHz | 173 |
| کارت گرافیک | MSI RTX 5070 Ti 16G INSPIRE 3X OC | 405 |
| هارد دیسک | اختیاری | - |
| کیس | DeepCool CC560 V2 | 15 |
| خنک کننده | AWEST GT-AV360E POLARIS B | 16 |
| پاور | CoolerMaster MWE GOLD 850 V3 | 19 |
| اس اس دی M.2 | Samsung SSD 990 EVO Plus 2TB | 75 |
بهترین سیستم پیشنهادی برای:
- برنامهنویسان و توسعهدهندگانی که از دستیارهای هوش مصنوعی (Aider، Continue و...) استفاده میکنند
- تحلیل پروژهها و سورسکدهای حجیم، کامپایل همزمان و ساخت Vector Embeddingها
- اجرای مدلهای تخصصی کدنویسی مثل Qwen 2.5 Coder و DeepSeek Coder
توسعه نرمافزار متکی بر AI برخلاف استنتاج معمولی متنی، نیازمند قدرت پردازشی سنگین در بخش CPU نیز هست. هنگام اجرای RAG (بازیابی اطلاعات از دیتابیسهای برداری) و Chunk کردن فایلهای سورسکد، پردازنده مرکزی نقش اصلی را در پارس کردن AST و ساخت نمایه متنی ایفا میکند. پردازنده ۱۲ هستهای و ۲۴ رشتهای Ryzen 9 9900X در این سیستم تضمین میکند که فرآیندهای کامپایل، تست و انبارش داده همزمان با اجرای هوش مصنوعی دچار کُندی نشوند.
کارت گرافیک RTX 5070 Ti با ۱۶ گیگابایت حافظه GDDR7، توانایی بینظیری در میزبانی از مدلهای مخصوص کدنویسی (Coder Models) دارد. این کارت به شما اجازه میدهد پنجرههای کانتکست طولانی (Context Length بیش از ۳۲ هزار توکن) را بدون مواجهه با خطای Out of Memory مدیریت کرده و تمام توابع و کلاسهای پروژه را یکجا به حافظه هوش مصنوعی بسپارید.
وجود 32 گیگابایت رم DDR5 و اساسدی پرسرعت PCIe 4.0 نیز سرعت خواندن و نوشتن بالا را در سرویسهایی مانند ChromaDB و Qdrant تضمین میکند. شما میتوانید بسته به نیاز روی این سیستم 64 گیگابایت رم نصب کنید که گزینه بهتری برای کاربردهای یاد شده است.
سیستم پیشنهادی شماره 4
سیستم حرفهای تولید تصویر و AI Creator
حداکثر قدرت پردازشی برای ComfyUI و FLUX
حدود 1.2 میلیارد تومان
| قطعه | مدل | قیمت |
|---|---|---|
| مادربرد | ASUS PRIME X870-P Wi-Fi | 53 |
| پردازنده | AMD Ryzen 9 9950X | 124 |
| رم | G.SKILL Trident Z5 RGB BLACK 64GB (2x32GB) 6000MHz | 310 |
| کارت گرافیک | ASUS ProArt RTX 5080 16GB | 545 |
| هارد دیسک | اختیاری | - |
| کیس | ASUS ProArt PA401 Mesh | 15 |
| خنک کننده | MSI MAG CORELIQUID A13 360 | 17 |
| پاور | Lian-Li SP1000 Platinum | 30 |
| اس اس دی M.2 | Samsung SSD 990 EVO Plus 2TB | 75 |
بهترین سیستم پیشنهادی برای:
- تولیدکنندگان محتوا، گرافیستها و فعالان حوزههای گرافیک مبتنی بر هوش مصنوعی
- تولید سریع تصویر و ویدیو با ابزارهای ComfyUI ،Stable Diffusion و FLUX.1 Dev
- پردازشهای سنگین محاسباتی مبتنی بر هستههای Tensor نسل جدید
مدلهای نسل جدید تولید تصویر مانند سری FLUX.1 به قدرت خام محاسباتی فوقالعاده بالایی برای مراحل Denoising و Sampling نیاز دارند. کارت گرافیک RTX 5080 با بهرهگیری از هستههای Tensor نسل جدید و حافظه پرسرعت GDDR7، زمان رندر تصاویر با رزولوشن high-res و 4K را به شکل چشمگیری کاهش داده و تولید ویدیوهای هوش مصنوعی را بسیار روان میسازد.
پردازنده پرچمدار ۱۶ هستهای Ryzen 9 9950X هم در کنار ۶۴ گیگابایت رم DDR5، زمان پیشپردازش (Pre-processing)، کدگذاری VAE و بارگذاری سریع سنگینترین لایههای Lora و ControlNet را به حداقل میرساند. این ترکیب باعث میشود ورکفلوهای پیچیده در ComfyUI بدون وقفه و با حداکثر راندمان اجرا شوند.
با توجه به بار کاری صد در صدی GPU و CPU در فرآیندهای رندر و آموزش LoRA، سیستم خنککننده مایع ۳۶۰ میلیمتری و کیس Full Tower با جریان هوای عالی جهت جلوگیری از Thermal Throttling انتخاب شدهاند. پاور ۱۰۰۰ وات با گواهی Gold و استاندارد ATX 3.1 نیز خیالی آسوده از بابت پایداری در فشار کاری مداوم فراهم میسازد.
سیستم پیشنهادی شماره 5
سیستم VRAM بالا (سیستم اقتصادی AMD)
24 گیگابایت حافظه گرافیکی با بستر ROCm
حدود 900 میلیون تومان
| قطعه | مدل | قیمت |
|---|---|---|
| مادربرد | ASUS PRIME X870-P Wi-Fi |
53 |
| پردازنده | AMD Ryzen 9 9900X | 99 |
| رم | G.SKILL Trident Z5 RGB BLACK 64GB (2x32GB) 6000MHz | 310 |
| کارت گرافیک | AMD Radeon RX 7900 XTX 24GB GDDR6 USED | 300 |
| هارد دیسک | اختیاری | - |
| کیس | ThermalTake View 270 TG ARGB V2 G6 | 17 |
| خنک کننده | DeepCool LE720 | 17 |
| پاور | Lian-Li SP1000 Platinum Black | 30 |
| اس اس دی M.2 | Samsung SSD 990 EVO Plus 2TB | 75 |
بهترین سیستم پیشنهادی برای:
- کاربرانی که اولویت اول آنها داشتن 24 گیگابایت VRAM است
- اجرای لوکال مدلهای ۳۲ میلیارد پارامتری بر بستر لینوکس و ویندوز با پلتفرم AMD ROCm
- استفاده از محیطهای Ollama و vLLM با پشتیبانی کارتهای سری RX 7000
اگر ظرفیت حافظه گرافیکی برای شما اولویت مطلق است اما بودجه کافی برای خرید پرچمداران انویدیا را ندارید، این کانفیگ مبتنی بر AMD Radeon RX 7900 XTX بهترین مسیر میانبر برای شماست. ۲۴ گیگابایت VRAM این کارت به شما اجازه میدهد مدلهای بزرگ ۳۲ میلیارد پارامتری یا نسخه کمحجم مدلهای ۷۰B را کاملاً داخل حافظه GPU جای دهید تا با افت سرعت ناشی از انتقال داده به رم سیستم مواجه نشوید.
با توسعه روزافزون پلتفرم AMD ROCm و پشتیبانی نیتیو PyTorch و Ollama از پردازندههای گرافیکی AMD، راهاندازی مدلهای زبانی محلی روی این کارت بسیار آسانتر از گذشته شده است. اگرچه در تولید تصویر و کتابخانههای CUDA انویدیا پیشتاز است، اما در حوزه استنتاج LLM، نسبت VRAM به قیمت در این کارت رقبا را به چالش میکشد.
پردازنده ۱۲ هستهای Ryzen 9 9900X هم در ترکیب با ۶۴ گیگابایت رم DDR5، تعادل سختافزاری کاملی را ایجاد کرده است.
سیستم پیشنهادی شماره 6
سیستم پرچمدار تککارت (RTX 5090 32GB)
ورود به دنیای مدلهای ۳۲ گیگابایتی و DeepSeek-R1
حدود 2.2 میلیارد تومان
| قطعه | مدل | قیمت |
|---|---|---|
| مادربرد | ASUS TUF GAMING X870E-PLUS WIFI7 | 92 |
| پردازنده | AMD Ryzen 9 9950X | 124 |
| رم | Corsair VENGEANCE RGB 64GB (2x32GB) 6000Mhz | 315 |
| کارت گرافیک | ASUS TUF RTX 5090 32GB | 1.430 |
| هارد دیسک | اختیاری | - |
| کیس | Cooler Master MasterFrame 600 | 37 |
| خنک کننده | MSI MAG CoreLiquid E360 | 18.5 |
| پاور | XPG CYBERCORE II 1300W PLATINUM | 45 |
| اس اس دی M.2 | Samsung SSD 990 EVO Plus 4TB | 140 |
بهترین سیستم پیشنهادی برای:
- اجرای روان مدلهای ۳۲ میلیارد پارامتری با دقت بالا (FP8/Q8)
- اجرای کوانتایزشده مدلهای 70B و DeepSeek-R1 روی یک کارت گرافیک
- کار با Context Lengthهای طولانی و عدم نگرانی از کمبود VRAM
اگر هدف شما اجرای حرفهای و تمامعیار مدلهای زبانی بدون درگیر شدن با پیچیدگیها، ناپایداریها و مصرف برق سیستمهای چندکارته (Multi-GPU) است، این کانفیگ سقف قدرت و کارایی در یک سیستم تککارت گرافیک محسوب میشود.
نقطه عطف این سیستم، حضور کارت گرافیک قدرتمند RTX 5090 با ۳۲ گیگابایت حافظه اختصاصی GDDR7 است. تا پیش از این، محدودیت ۱۶ یا ۲۴ گیگابایتی کارتهای گرافیک باعث میشد تا برای اجرای مدلهای فراتر از ۱۴ میلیارد پارامتر، مجبور به کوانتایز شدید (کاهش افت کیفیت) یا استفاده از رم سیستم شوید. اما با ۳۲ گیگابایت VRAM و پهنای باند فوقالعاده حافظههای GDDR7، میتوانید مدلهای محبوب 32B (مانند Qwen 2.5 32B یا Command R) را با بالاترین دقت عددی (FP8 یا Q8) و بدون کوچکترین افت کیفیتی اجرا کنید.
علاوه بر این، ظرفیت ۳۲ گیگابایتی VRAM فضای بسیار سخاوتمندانهای برای KV Cache در اختیارتان میگذارد؛ به این معنی که میتوانید Context Window را تا اعداد بالایی مثل 32K یا 64K بالا ببرید، بدون اینکه با خطای شایع کمبود حافظه (Out of Memory) مواجه شوید. حتی اجرای نسخه کوانتایزشده مدلهای استدلالگر و سنگینی مثل DeepSeek-R1 یا Llama 70B روی این تککارت امکانپذیر است و سرعتی تا چند برابر سیستمهای مبتنی بر Offload ارائه میدهد.
در کنار کارت گرافیک، پردازنده ۱۶ هستهای Ryzen 9 9950X، مقدار ۶۴ گیگابایت حافظه رم پرسرعت DDR5 و یک اساسدی ۴ ترابایتی سامسونگ قرار گرفتهاند تا بارگذاری فایلهای چند ده گیگابایتی مدلها در چند ثانیه انجام شود. همچنین انتخاب پاور ۱۳۰۰ واتی پلاتینیوم و خنککننده ۳۶۰ میلیمتری، پایداری و سلامت قطعات را در پردازشهای سنگین و طولانیمدت AI تضمین میکند.
سیستم پیشنهادی شماره 7
سیستم سنگین RAG و پردازش اسناد سازمانی
ترکیب ۳۲ گیگابایت VRAM و ۱۲۸ گیگابایت رم سیستم
حدود 2.3 میلیارد تومان
| قطعه | مدل | قیمت |
|---|---|---|
| مادربرد | ASUS TUF GAMING X870E-PLUS WIFI7 | 92 |
| پردازنده | AMD Ryzen 9 9950X | 124 |
| رم | Corsair VENGEANCE RGB 96GB (2x48GB) 5200Mhz | 410 |
| کارت گرافیک | ASUS TUF RTX 5090 32GB | 1.430 |
| هارد دیسک | اختیاری | - |
| کیس | ThermalTake CTE C750 AIR | 33 |
| خنک کننده | ThermalTake TH360 V2 Ultra ARGB Black Sync | 28 |
| پاور | MSI MEG Ai1300P | 57 |
| اس اس دی M.2 | Samsung SSD 990 EVO Plus 4TB | 140 |
بهترین سیستم پیشنهادی برای:
- پردازش اسناد بسیار حجیم سازمانی، هزاران فایل PDF و جستجوهای برداری سنگین
- نگهداری پایگاهدادههای برداری بزرگ در حافظه رم بدون ایجاد گلوگاه
- استفاده حرفهای از تکنیک RAG با Context Windowهای طولانی
اجرای پروژههای RAG (تولید مبتنی بر بازیابی) در مقیاس سازمانی، چالش متفاوتی نسبت به اجرای ساده یک مدل زبانی دارد. در این سناریو سیستم شما فقط یک پاسخدهنده نیست؛ بلکه باید همزمان هزاران سند، فایل PDF، قرارداد و پایگاهداده برداری (Vector DB) را پردازش، نمایه (Index) و در حافظه نگهداری کند. این کانفیگ دقیقاً برای رفع همین گلوگاههای پیچیده طراحی شده است.
اصلیترین رکن در پردازش اسناد حجیم، حافظه RAM قدرتمند و پرسرعت است. این سیستم با داشتن 96 گیگابایت رم DDR5، به شما اجازه میدهد پایگاههای داده برداری سنگین (مانند Milvus، Qdrant یا ChromaDB) را به طور کامل درون حافظه اصلی بگذارید. این موضوع باعث میشود جستجوی تشابهات (Similarity Search) میان میلیونها پاراگراف و سند بدون کوچکترین وقفه انجام شود و موقع استفاده از Context Windowهای بسیار طولانی (مثلاً 64K یا 128K)، سیستم با کندی یا خطا مواجه نشود.
البته ترجیح ما انتخاب 128 گیگابایت حافظه رم بود، اما به دلیل شرایط کمبود و گرانی کنونی ناچار به تقلیل آن به 96 گیگابایت شدیم. همچنین از آنجایی که کیت انتخابی مخصوص اینتل است، ممکن است ناچار به استفاده از آن با فرکانس استاندارد شوید که به دلیل کمبود موجودی بازار قابل چشمپوشی است.
در کنار اهمیت بالای RAM برای این سیستم هوش مصنوعی، پردازنده ۱۶ هستهای Ryzen 9 9950X نقش موتور پیشپردازش را ایفا میکند. قبل از اینکه دادهها به هوش مصنوعی سپرده شوند، این CPU است که وظیفه استخراج متن، OCR اسناد اسکنشده، چانکبندی (Chunking) و تولید امبدینگها (Embeddings) را با بالاترین سرعت ممکن انجام میدهد.
نهایتاً، حضور قدرتمندترین کارت گرافیک دنیا، RTX 5090 با ۳۲ گیگابایت VRAM، خیالتان را از بابت بخش تولید پاسخ (Generation) راحت میکند. این میزان حافظه گرافیکی اجازه میدهد مدلهای قدرتمندی مثل Llama 3 یا DeepSeek را با بالاترین دقت فراخوانی کنید تا بر اساس دادههای استخراجشده از اسناد سازمانی شما، دقیقترین خروجی ممکن را بدون ارسال هیچ دادهای به سرورهای ابری خارجی تولید کنند.
سیستم پیشنهادی شماره 8
ورکاستیشن توسعهدهندگان (AI Dev Workstation)
۱۹۲ گیگابایت رم و ۸ ترابایت فضای ذخیرهسازی فوق سریع
| قطعه | مدل | قیمت |
|---|---|---|
| مادربرد | ASUS ProArt X870E-Creator Wi-Fi | 123 |
| پردازنده | AMD Ryzen 9 9950X | 124 |
| رم | Corsair VENGEANCE RGB 96GB (2x48GB) 5200Mhz | 410 |
| کارت گرافیک | ASUS TUF RTX 5090 32GB | 1.430 |
| هارد دیسک | اختیاری | - |
| کیس | Lian-Li O11 Dynamic EVO XL | 57 |
| خنک کننده | MSI MEG CORELIQUID S360 | 43 |
| پاور | Cooler Master V Platinum 1600 V2 | 68 |
| اس اس دی M.2 | Samsung SSD 9100 PRO 4TB x2 | 650 |
بهترین سیستم پیشنهادی برای:
- توسعهدهندگان حرفهای هوش مصنوعی، برنامهنویسی Agentic و تست همزمان چند مدل
- نگهداری دهها فایل وزن مدل (Safetensors و GGUF) روی حافظه SSD
- انجام GPU Offloading سنگین روی حافظه سیستم هنگام تست مدلهای بزرگ
اگر به عنوان یک توسعهدهنده، پژوهشگر یا برنامهنویس هوش مصنوعی بهدنبال سیستمی هستید که بدون دغدغه کمبود حافظه، سنگینترین سناریوهای Local AI را اجرا کند، این ورکاستیشن قدرتمند دقیقاً برای شما طراحی شده است.
قلب تپنده این سیستم، کارت گرافیک بیرقیب RTX 5090 با ۳۲ گیگابایت VRAM است که با ظرفیت بینظیر خود امکان اجرای مستقیم و پرسرعت مدلهای ۳۲ میلیارد پارامتری (32B) با بالاترین دقت و حتی اجرای مدلهای سنگینتر تصویری و ویدیویی مانند FLUX را بدون کوچکترین گلوگاهی فراهم میکند.
اما مزیت رقابتی اصلی این سیستم، مجهز بودن به 96 گیگابایت حافظه RAM پرسرعت DDR5 است. این حجم فوقالعاده از رم، دست شما را برای تکنیک GPU Offloading کاملاً باز میگذارد؛ یعنی اگر بخواهید مدلهای غولپیکری مثل DeepSeek-R1 یا Llama 70B را روی سیستم اجرا کنید، لایههای مازاد مدل بهراحتی روی RAM سیستم بارگذاری میشوند تا سیستم دچار کرش یا کمبود حافظه نشود. البته بسته به موجودی بازار و نیازتان میتوانید 192 گیگابایت رم نصب کنید.
علاوه بر این در پروژههای پیشرفته RAG (پردازش و پایگاهدادههای برداری از حجم عظیمی از اسناد) و سیستمهای Agentic AI که چندین مدل باید بهطور همزمان در حافظه فعال باشند، این میزان رم تضمینکننده روانی کامل فرایند است.
استفاده از دو اساسدی ۴ ترابایتی PCIe 5.0 سامسونگ نه تنها فضایی وسیع برای آرشیو دهها فایل سنگین وزن مدل (Safetensors و GGUF) در اختیارتان میگذارد، بلکه به لطف سرعت خواندن بینظیر نسل جدید، زمان بارگذاری مدلهای چند ده گیگابایتی روی VRAM را به چند ثانیه میرساند.
در نهایت، ترکیب پردازنده ۱۶ هستهای Ryzen 9 9950X و مادربرد ورکاستیشن ProArt X870E در کنار خنککننده ۳۶۰ میلیمتری و پاور ۱۶۰۰ واتی پلاتینیوم، پایداری ۱۰۰ درصدی این سیستم را در پردازشهای سنگین و مداوم شبانهروزی (۲۴/۷) تضمین میکند.
جمعبندی
خرید سیستم برای اجرای محلی هوش مصنوعی بیشتر از آنکه به قدرت خام پردازشی وابسته باشد، به ظرفیت و پهنای باند حافظه، بهویژه VRAM گره خورده است. البته RAM، CPU و سازگاری نرمافزاری نیز بسته به نوع استفاده اهمیت پیدا میکنند. برای انتخاب سیستم مناسب، میتوانید این سه اصل را در نظر بگیرید که در ادامه میگوییم.
اگر تمرکز شما روی مدلهای سبک زبانی 7B/8B یا تولید تصویر پایه است، کارتهایی با ۱۲ گیگابایت VRAM در کنار ۳۲ گیگابایت RAM میتوانند نقطه شروع مناسبی باشند.
برای مدلهای متوسط 14B تا 32B و مدلهای تصویری سنگینتر مانند FLUX، کارتهای ۱۶ تا ۲۴ گیگابایتی معمولاً انعطاف بیشتری در اختیار شما قرار میدهند و در بسیاری از سناریوها انتخاب منطقیتری نسبت به کارتهای کمحافظهتر هستند.
اگر هدف شما اجرای مدلهای ۷۰ میلیارد پارامتری یا مدلهایی مانند DeepSeek-R1 است، باید سراغ کارتهای گرافیک با VRAM بالا، پیکربندیهای Multi-GPU یا سیستمهایی با Unified Memory زیاد مانند برخی مدلهای Mac Studio بروید.
در نهایت بهترین سیستم Local AI الزاماً گرانترین سیستم موجود نیست. مهم این است که سختافزار را بر اساس مدلهایی که واقعاً قصد اجرای آنها را دارید، حجم Context، روش Quantization و نرمافزار مورد استفاده انتخاب کنید. در بسیاری از موارد، اختصاص بودجه بیشتر به VRAM نتیجه بهتری از خرید یک GPU سریعتر اما کمحافظهتر خواهد داشت.
پرسشهای متداول
برای اجرای هوش مصنوعی لوکال چند گیگابایت RAM لازم است؟
برای یک سیستم عمومی Local AI، ۳۲ گیگابایت RAM نقطه شروع مناسبی است. اگر قصد اجرای مدلهای بزرگتر با GPU Offloading، پردازش اسناد حجیم یا استفاده سنگین از RAG را دارید، بهتر است سراغ ۶۴ تا ۱۲۸ گیگابایت RAM بروید.
برای Local AI چند گیگابایت VRAM لازم است؟
برای مدلهای سبک، ۸ گیگابایت VRAM میتواند کافی باشد. برای کاربری استاندارد و مدلهای 7B/8B و 14B کوانتایزشده، ۱۲ تا ۱۶ گیگابایت انتخاب مناسبتری است. برای مدلهای بزرگتر مانند 32B و بالاتر، یا پروژههای سنگینتر، ۲۴ تا ۳۲ گیگابایت VRAM و بیشتر انعطاف بسیار بیشتری ایجاد میکند.
آیا اجرای هوش مصنوعی بدون کارت گرافیک امکانپذیر است؟
بله. مدلهای هوش مصنوعی را میتوان روی CPU و RAM سیستم اجرا کرد و سیستمهای مجهز به حافظه یکپارچه مانند Mac نیز میتوانند از همین معماری برای اجرای مدلها استفاده کنند. با این حال، در بسیاری از مدلها سرعت تولید توکن روی یک CPU معمولی بهمراتب پایینتر از GPU خواهد بود.
بهترین کارت گرافیک برای Local AI چیست؟
در حال حاضر کارتهای NVIDIA به دلیل پشتیبانی گسترده از CUDA و سازگاری مناسب با طیف وسیعی از ابزارها و فریمورکهای هوش مصنوعی، معمولاً انتخاب کمدردسرتری هستند. بسته به بودجه و نیاز، کارتهایی مانند RTX 3060 12GB، RTX 4060 Ti 16GB، RTX 4090 24GB و RTX 5090 32GB میتوانند گزینههای مناسبی در ردههای مختلف باشند.
آیا RTX 5090 برای اجرای هوش مصنوعی مناسب است؟
بله. RTX 5090 با ۳۲ گیگابایت حافظه GDDR7 و هستههای Tensor نسل جدید، از قدرتمندترین کارتهای گرافیک دسکتاپ برای اجرای محلی مدلهای زبانی و مدلهای سنگین تولید تصویر محسوب میشود. ظرفیت ۳۲ گیگابایتی VRAM نیز امکان اجرای مدلهای بزرگتری را بدون نیاز به Offloading فراهم میکند.
برای اجرای مدلهای 7B چه سیستمی لازم است؟
برای مدلهای 7B/8B کوانتایزشده، یک کارت گرافیک با ۸ تا ۱۲ گیگابایت VRAM در کنار ۳۲ گیگابایت RAM و یک پردازنده مدرن ۶ هستهای میتواند برای بسیاری از کاربردهای معمول کافی باشد.
برای اجرای مدل 14B چه سیستمی لازم است؟
برای مدلهای 14B کوانتایزشده، کارت گرافیک با ۱۲ تا ۱۶ گیگابایت VRAM، مانند RTX 4060 Ti 16GB، در کنار ۳۲ تا ۶۴ گیگابایت RAM و یک پردازنده مدرن ۸ هستهای انتخاب مناسبتری است. البته نیاز واقعی به حافظه به روش Quantization و اندازه Context نیز بستگی دارد.
آیا 16 گیگابایت RAM برای هوش مصنوعی کافی است؟
برای اجرای مدلهای کوچک و آزمایشهای اولیه ممکن است ۱۶ گیگابایت RAM کافی باشد، اما برای یک سیستم امروزی که قرار است همزمان ویندوز، ابزارهای Local AI و سایر برنامهها را اجرا کند، ۳۲ گیگابایت RAM انتخاب منطقیتری است و فضای بیشتری برای مدل و پردازشهای جانبی باقی میگذارد.
آیا 32 گیگابایت RAM برای Local AI کافی است؟
بله. برای بسیاری از کاربران خانگی، گیمرها و اجرای مدلهای 7B تا 14B، ظرفیت ۳۲ گیگابایت میتواند کاملاً کافی باشد. اگر سراغ مدلهای بزرگتر، GPU Offloading یا پردازش اسناد سنگین بروید، افزایش RAM به ۶۴ گیگابایت یا بیشتر منطقی خواهد بود.
برای اجرای LLM، RAM مهمتر است یا VRAM؟
اگر قرار است مدل روی GPU اجرا شود، VRAM اهمیت بیشتری دارد؛ زیرا ظرفیت و پهنای باند حافظه GPU مستقیماً روی امکان اجرای مدل و سرعت پردازش آن تأثیر میگذارد. RAM زمانی اهمیت بیشتری پیدا میکند که مدل از ظرفیت VRAM بزرگتر باشد یا سیستم برای کارهایی مانند RAG و پردازش اسناد به حافظه بیشتری نیاز داشته باشد.
آیا Local AI روی لپتاپ اجرا میشود؟
بله. لپتاپهای مجهز به GPU مجزا با VRAM کافی میتوانند مدلهای هوش مصنوعی را بهصورت محلی اجرا کنند. برای کاربردهای جدیتر بهتر است حداقل به سراغ مدلهایی با ۸ تا ۱۶ گیگابایت VRAM بروید. لپتاپهای مجهز به Apple Silicon نیز به دلیل استفاده از Unified Memory گزینه دیگری برای اجرای Local AI هستند.
آیا مک برای اجرای هوش مصنوعی لوکال مناسب است؟
بله. سیستمهای مک مجهز به تراشههای Apple Silicon، بهخصوص مدلهای Pro، Max و Ultra، به لطف Unified Memory با ظرفیت بالا میتوانند برای اجرای مدلهای بزرگ جذاب باشند. در این سیستمها CPU و GPU از حافظه مشترک استفاده میکنند و همین موضوع امکان بارگذاری مدلهایی را فراهم میکند که ممکن است روی یک GPU با VRAM کمتر قابل اجرا نباشند.
آیا برای Local AI حتماً NVIDIA لازم است؟
خیر. کارتهای AMD با استفاده از ROCm و سیستمهای مجهز به Apple Silicon نیز میتوانند برای اجرای Local AI استفاده شوند. با این حال، NVIDIA به دلیل پشتیبانی گستردهتر از CUDA و سازگاری با تعداد زیادی از کتابخانهها و ابزارهای هوش مصنوعی، معمولاً مسیر سادهتر و کمدردسرتری را در اختیار کاربر قرار میدهد.
Quantization چیست و چه تأثیری روی سختافزار دارد؟
Quantization یا کوانتایزیشن روشی برای کاهش دقت عددی وزنهای مدل، مثلاً از 16-bit به 4-bit، است. این کار حجم مدل و میزان حافظه مورد نیاز برای اجرای آن را به شکل قابلتوجهی کاهش میدهد و در بسیاری از موارد امکان اجرای مدلهای بزرگتر روی سختافزارهای معمولی را فراهم میکند. در مقابل، بسته به مدل و روش Quantization ممکن است مقداری از کیفیت خروجی کاهش پیدا کند.
آیا میتوان مدلهای بزرگ را با CPU اجرا کرد؟
بله. با ابزارهایی مانند llama.cpp میتوان مدلهای بزرگ را در RAM سیستم بارگذاری و با CPU اجرا کرد. مشکل اصلی سرعت است؛ در بسیاری از مدلها سرعت تولید توکن با CPU معمولی بسیار پایینتر از اجرای همان مدل روی GPU خواهد بود. به همین دلیل، اگر هدف اجرای سریع و روان LLM باشد، استفاده از GPU با VRAM کافی معمولاً انتخاب بهتری است.





نظر خود را اضافه کنید.
برای ارسال نظر وارد شوید
ارسال نظر بدون عضویت در سایت