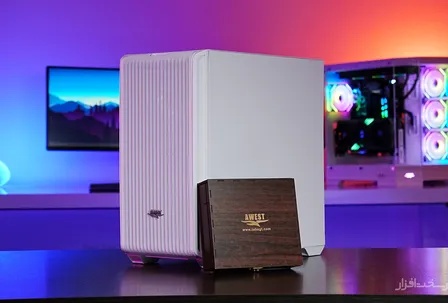
اگر یک کامپیوتر کوچک بتواند مدلهای هوش مصنوعی را بدون اینترنت و با سرعتی چشمگیر اجرا کند، چقدر به سختافزار قدرتمند نیاز داریم؟ نتایج آزمایش تازهای روی مک مینی M6 نشان میدهد اپل در اجرای محلی AI، پیشرفت قابل توجهی داشته است. در این مقایسه، M6 در برخی وظایف هوش مصنوعی فاصله زیادی با نسل M4 ایجاد میکند.
تراشههای اپل مدتهاست به بهرهوری انرژی و عملکرد مناسب در ابعاد کوچک شناخته میشوند. اما اجرای مدلهای هوش مصنوعی، معیارهای سختتری پیش روی سختافزار میگذارد. در یک آزمایش جدید که جهت بررسی عملکرد اپل M6 انجام شده، این تراشه رشد عملکرد قابل توجهی در اجرای برخی وظایف AI از خود نشان داده است.
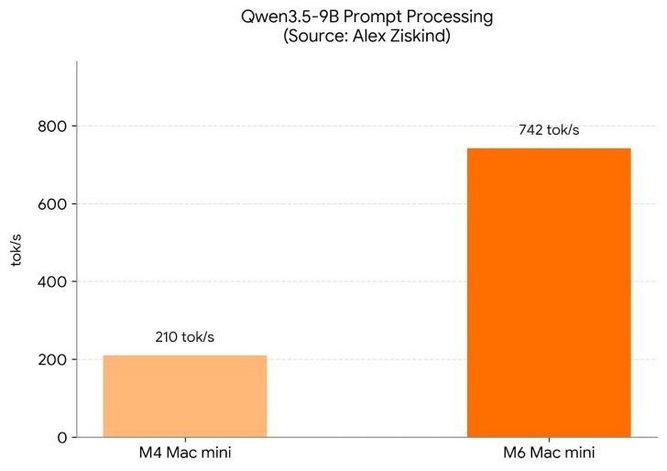
M6 در پردازش Prompt بیش از سه برابر سریعتر است
در آزمایشی که Alex Ziskind انجام داده و Wccftech گزارش آن را منتشر کرده است، مک مینی M6 در اجرای مدل Qwen3.5-9B با کوانتایز 4-bit به سرعت ۷۴۲ توکن بر ثانیه رسیده است. M4 در همین آزمون ۲۱۰ توکن بر ثانیه ثبت کرده. به زبان ساده، M6 در پردازش ورودی مدل حدود ۳.۵ برابر سریعتر عمل کرده است.
اما به نسبت مورد فوق اختلاف در تولید پاسخ کمتر است؛ M6 سرعت ۲۶.۹ توکن بر ثانیه و M4 سرعت ۱۸ توکن بر ثانیه دارد.
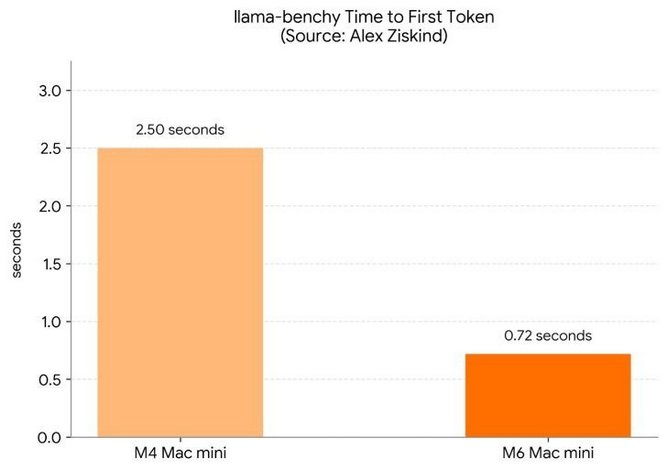
زمان تولید نخستین توکن هم از ۲.۵ ثانیه در M4 به ۰.۷۲ ثانیه در M6 کاهش پیدا کرده است. این تفاوتها میتوانند در سرعت آمادهسازی مدل و روانی گفتوگو با دستیار هوش مصنوعی محسوس باشند.
تولید تصویر با FLUX.1 در ۳۶ ثانیه
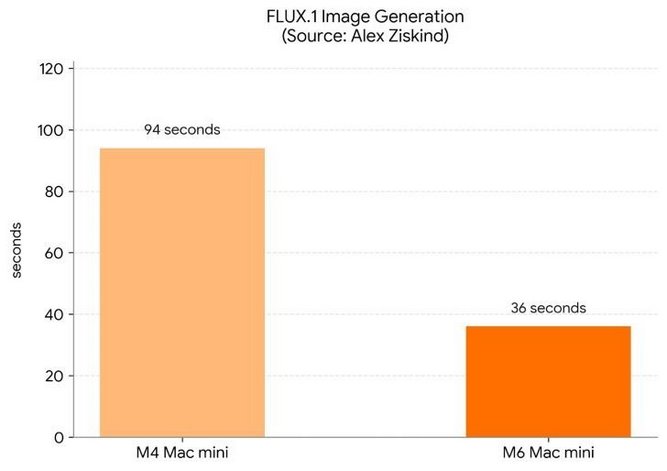
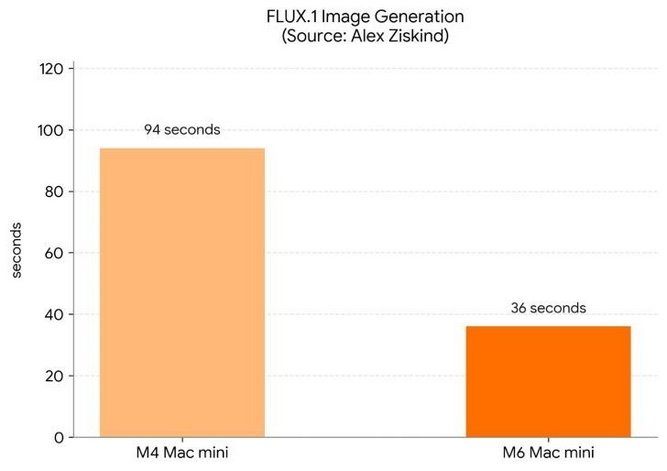
M6 در آزمایش تولید تصویر با FLUX.1 هم عملکرد بهتری داشته است. مک مینی جدید تصویر آزمایشی را در ۳۶ ثانیه تولید کرده، در حالی که M4 برای همین هدف و با پرامپ یکسان به بیش از ۹۰ ثانیه زمان نیاز داشته است.
این نتیجه برای کاربرانی که تصاویر را بهصورت محلی تولید میکنند، جالب است. البته زمان ثبتشده به مدل و تنظیمات همان آزمون مربوط میشود و نمیتوان آن را به تمام ابزارهای تولید تصویر تعمیم داد.
حافظه یکپارچه و اجرای مدلهای بزرگتر
نکته بسیار مهم دیگر که در گزارش فوق به آن اشاره شده، افزایش پهنای باند حافظه یکپارچه M6 و اضافهشدن Neural Accelerator به هستههای GPU است. از دید فنی هر چه رم مورد دسترس برای پردازنده (چه CPU و چه GPU) سریعتر باشد، سرعت رسیدن به نتیجه بیشتر میشود. البته باید اشاره کنیم که اگرچه این تغییرات میتوانند در بهبود عملکرد AI نقش مهمی داشته باشند، اما تعیین سهم دقیق هرکدام به بررسیهای فنی بیشتری نیاز دارد.
وجه دیگر داستان این است که ظرفیت حافظه نیز در خصوص سرعت پردازش، اهمیت زیادی دارد. طبق همین گزارش، مک مینی M6 با ۳۲ گیگابایت حافظه یکپارچه توانسته مدل Qwen3.8 با 28 میلیارد پارامتر را اجرا کند. اجرای مدلهای بزرگتر به حافظه کافی نیاز دارد و به همین دلیل، ظرفیت حافظه در سیستمهای مخصوص هوش مصنوعی محلی اهمیت ویژهای پیدا میکند.
مصرف برق کمتر، قیمت بالاتر برای مک مینی M6
مک مینی M6 در کنار عملکرد بالاتر، خنکتر و کممصرفتر از نسل M4 کار میکند. اندازهگیری مصرف برق نشان میدهد مدل جدید به ۳۸ وات انرژی نیاز دارد، درحالیکه مصرف مدل مجهز به M4 به ۴۴ وات میرسد. این کاهش مصرف، با وجود افزایش عملکرد پردازشی، نکته مثبتی برای بهرهوری انرژی است.
نقطهضعف اصلی M6 به قیمت آن برمیگردد. هنگام انتشار گزارش، مدل پایه مک مینی M6 با ۱۶ گیگابایت حافظه یکپارچه و ۲۵۶ گیگابایت فضای ذخیرهسازی با قیمت ۸۷۹.۹۹ دلار در آمازون عرضه میشود. این در حالی است که مک مینی M4 با قیمت پایه ۵۹۹ دلار وارد بازار شده بود. بنابراین، خریداران برای تجربه عملکرد بالاتر M6 باید نزدیک به ۳۰۰ دلار بیشتر هزینه کنند.
در نهایت نتایج آزمایش Alex Ziskind نشان میدهد M6 در اجرای برخی مدلهای هوش مصنوعی محلی، بهخصوص پردازش Prompt و تولید تصویر، فاصله قابل توجهی با M4 دارد. سرعت بالاتر و امکان اجرای مدلهای بزرگتر با حافظه کافی، مک مینی M6 را به گزینهای جالب برای علاقهمندان به AI بدون اینترنت تبدیل میکند.
با این حال، این اعداد به آزمونهای مشخص مربوط هستند و برای مقایسه جامع دو تراشه، باید مدلها و نرمافزارهای بیشتری بررسی شوند.






نظر خود را اضافه کنید.
برای ارسال نظر وارد شوید
ارسال نظر بدون عضویت در سایت