برای اجرای هوش مصنوعی روی لپتاپ، خرید گرانترین مدل بازار همیشه بهترین تصمیم نیست. مقدار VRAM، قدرت GPU، حافظه RAM و نوع مدل موردنظر تعیین میکنند کدام دستگاه واقعاً پاسخگوی نیاز شماست. در این راهنما، لپتاپهای مناسب Local AI را از گزینههای اقتصادی تا مدلهای حرفهای بررسی میکنیم.
مقدمه
وقتی قرار است یک لپتاپ را برای اجرای هوش مصنوعی انتخاب کنیم، اولین وسوسه این است که سراغ قویترین پردازنده و جدیدترین کارت گرافیک برویم. انتخابی که روی کاغذ منطقی به نظر میرسد، اما در عمل همیشه جواب نمیدهد. برای اجرای مدلهای Local AI، فقط قدرت پردازشی مهم نیست؛ مقدار حافظهای که مدل در اختیار دارد، ظرفیت و پهنای باند VRAM، توان مصرفی GPU و البته پشتیبانی نرمافزاری، گاهی بیشتر از نام پردازنده یا نسل لپتاپ روی نتیجه نهایی اثر میگذارند.
حالا حافظه یکپارچه (Unified Memory) را هم به این معادله اضافه کنید. در لپتاپهایی با این معماری، CPU و GPU از یک فضای حافظه مشترک استفاده میکنند و همین موضوع مقایسه آنها با مدلهای مجهز به کارت گرافیک مجزا را ساده نمیگذارد. مقدار حافظه تنها بخشی از ماجراست؛ اینکه GPU چگونه به آن دسترسی پیدا میکند و نرمافزار موردنظر چطور از این منابع استفاده میکند، اهمیت خودش را دارد.
در بازار ایران، انتخاب سختافزار مناسب یک محدودیت دیگر هم دارد: همه مدلهای جدید و قدرتمند بهراحتی پیدا نمیشوند و قیمت بعضی از آنها هم بهقدری بالاست که خریدشان برای هر کاربری توجیه ندارد. به همین دلیل، نباید مدلهای یکی دو نسل قبل را صرفاً به خاطر قدیمیتر بودن کنار گذاشت. گاهی یک لپتاپ با GPU مناسب و VRAM کافی، با وجود سختافزار قدیمیتر، میتواند نیاز شما را با هزینه کمتری برآورده کند.
در این راهنما، ابتدا سراغ لپتاپهایی میرویم که در ردههای قیمتی مختلف بازار ایران میتوانند برای اجرای Local AI مناسب باشند. بعد، مشخصات فنی آنها را دقیقتر بررسی میکنیم تا روشن شود چرا یک مدل در فهرست قرار گرفته و مدل دیگری با وجود مشخصات ظاهراً جذاب، انتخاب مناسبی نیست. از GPU و VRAM گرفته تا حافظه سیستم، Unified Memory و NPU، هرکدام را از زاویه کاربرد واقعی بررسی خواهیم کرد؛ چون در نهایت قرار نیست صرفاً لپتاپ قدرتمندتری بخریم، بلکه باید دستگاهی را پیدا کنیم که از پس مدلها و کارهایی که مدنظر داریم بر بیاید و در برابر هزینهای که میپردازیم، انتخاب قابل دفاعی باشد.
در همین رابطه بخوانید:
- بهترین کارت گرافیک برای هوش مصنوعی
- راهنمای خرید بهترین رم برای هوش مصنوعی
- بهترین پردازنده برای اجرای هوش مصنوعی چیست؟
بهترین لپتاپهای بازار ایران برای Local AI
اگر قرار است برای اجرای محلی مدلهای هوش مصنوعی لپتاپ بخرید، از همان ابتدا یک نکته را در نظر داشته باشید: گرانترین گزینه لزوماً مناسبترین انتخاب برای شما نیست. بهتر است ابتدا مشخص کنید قرار است چه مدلهایی را با چه ابعادی اجرا کنید و از لپتاپ خود چه انتظاری دارید؛ بعد سراغ سختافزاری بروید که بتواند این نیازها را با هزینهای منطقی پوشش دهد.
در Local AI، داشتن قدرتمندترین GPU یا بیشترین مقدار RAM بهتنهایی یک لپتاپ را به بهترین گزینه تبدیل نمیکند. حافظهای که واقعاً در اختیار مدل قرار میگیرد، توان پردازشی شتابدهنده، سازگاری نرمافزاری، قابلیت حمل و البته قیمت، همگی در انتخاب نهایی اثر دارند. به همین دلیل، مدلهای این فهرست را بر اساس کاربرد و سناریوی استفاده انتخاب کردهایم، نه اینکه بخواهیم یک برنده مطلق برای همه کاربران معرفی کنیم.
برای شروع هم لزوماً به یک لپتاپ گرانقیمت نیاز ندارید. اگر هدفتان فقط آزمایش و اجرای پایه مدلهای کوچکتر از 12B است، یک لپتاپ نسبتاً جدید، مثلاً از سال 2022 به بعد، با پردازنده Core i5 یا Ryzen 5، گرافیک مجتمع (iGPU) و حداقل 16 گیگابایت RAM میتواند نقطه شروع باشد. البته این ترکیب را نباید با یک سیستم مناسب برای کار حرفهای اشتباه گرفت. وقتی پای مدلهای بزرگتر، اجرای سریعتر یا استفاده جدیتر از Local AI به میان میآید، توان پردازشی GPU مجزا و حافظه اختصاصی آن اهمیت بیشتری پیدا میکند.
پیش از اینکه به سراغ بررسی معیارهای فنی برویم، میتوانید در جدول زیر لپتاپهای پیشنهادی را بر اساس نوع استفاده و بودجه ببینید. در ادامه، دلیل انتخاب هر مدل و محدودیتهایی را که باید هنگام خرید در نظر بگیرید، دقیقتر بررسی خواهیم کرد.
| مدل پیشنهادی | CPU + GPU | VRAM و RAM | مناسب برای |
|---|---|---|---|
| ASUS TUF Gaming F16 | Core Ultra + RTX 5060 | 8GB VRAM + 16/32GB RAM | مدلهای 3B تا 8B، Coding سبک، RAG سبک و یادگیری Local AI |
| ASUS ROG Strix G16 | Ryzen 9 / Core Ultra + RTX 5070 Ti | 12GB VRAM + 32GB RAM | LLMهای متوسط، Coding، RAG، تولید تصویر و کاربری ترکیبی |
| MSI Vector 16 HX AI | Core Ultra 9 275HX + RTX 5080 | 16GB VRAM + 32/64GB RAM | تولید تصویر و ویدئو، LLMهای متوسط و سنگینتر، CUDA و Workloadهای حرفهای GPUمحور |
| HP OMEN MAX 16 | Ryzen AI 9 HX 375 + RTX 5080 | 16GB VRAM + 32GB RAM | LLMهای متوسط و سنگینتر، تولید تصویر و ویدئو و Workloadهای GPUمحور |
| ASUS ROG Zephyrus G16 | Core Ultra + RTX 5080 | 16GB VRAM + 32/64GB RAM | Local AI، بازی و کار حرفهای برای کاربری که قابلیت حمل اهمیت دارد |
| Lenovo Legion Pro 7i | Core Ultra ردهبالا + RTX 5090 | 24GB VRAM + 32/64GB RAM | مدلهای بزرگتر، CUDA، تولید تصویر سنگین و Workloadهای حرفهای |
| ASUS ROG Flow Z13 GZ302 | Ryzen AI Max+ 395 + Radeon 8060S | 64/128GB Unified Memory | LLMهای بزرگتر، کاربری حافظهمحور، Offload و اجرای مدل در دستگاه قابلحمل |
| MacBook Pro 16 M5 Max/Pro | M5 Max/Pro، GPU 40-core | 64/128GB Unified Memory | LLMهای بزرگ، RAG، توسعه AI و Workloadهای حافظهمحور با مصرف و قابلیت حمل مناسب |
توجه داشته باشید که برای AI PC لزوماً نیازی به Local AI Workstation نیست. لپتاپهای مجهز به NPU قدرتمند برای قابلیتهای AI روزمره مناسباند، اما برای LLMهای سنگین، تولید تصویر و مدلهای بزرگ همچنان ظرفیت حافظه و قدرت GPU اهمیت بیشتری دارند.
لپ تاپ ASUS TUF Gaming F16 با RTX 5060؛ نقطه ورود به Local AI حرفهای
لپ تاپ ایسوس تاف گیمینگ اف 16
قیمت: حدود 400 میلیون تومان با گارانتی معتبر
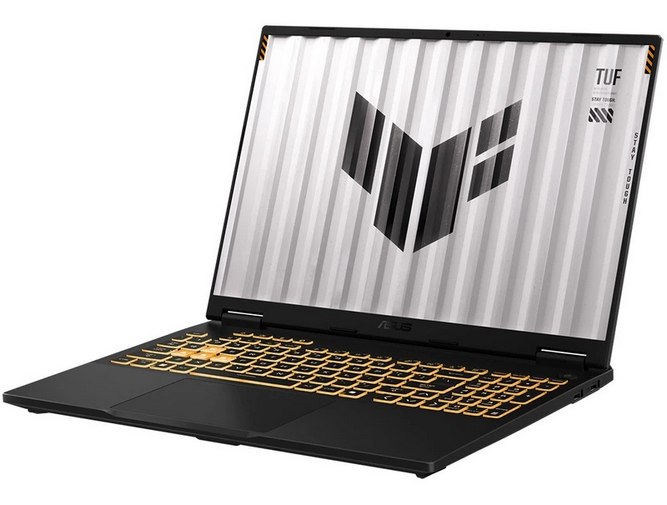
برای کاربری که میخواهد Local AI را یاد بگیرد، مدلهای کوچکتر اجرا کند یا AI تنها یکی از کاربردهای لپتاپ است، RTX 5060 با 8GB VRAM میتواند نقطه ورود مناسبی باشد. این مقدار حافظه برای مدلهای سبک و برخی Workflowهای تصویری قابل استفاده است، اما برای آیندهنگری Local AI محدودیت مهمی محسوب میشود.
در این رده بهتر است به جای پرداخت هزینه زیاد برای 64GB RAM، ابتدا مطمئن شوید که 8GB VRAM واقعاً پاسخگوی مدلهای موردنظر شماست. RAM بیشتر نمیتواند جای VRAM ناکافی را در اجرای سریع GPUمحور بگیرد.
مناسب برای: مدلهای 3B تا 8B، Coding سبک، RAG سبک، یادگیری و آزمایش Local AI.
لپ تاپ ASUS ROG Strix G16 با RTX 5070 Ti؛ انتخاب متعادل NVIDIA
لپ تاپ ایسوس آر اوجی استریکس جی 16
قیمت: حدود 415 میلیون تومان با گارانتی معتبر
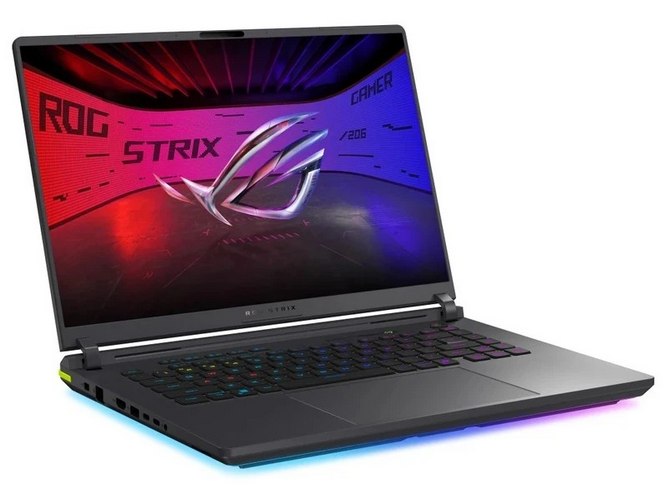
لپتاپهای مجهز به RTX 5070 Ti با 12GB GDDR7 را میتوان یکی از متعادلترین گزینههای نسل جدید NVIDIA برای Local AI دانست. این GPU با 5888 هسته CUDA، قدرت پردازشی مناسبی برای LLMهای متوسط، تولید تصویر، Coding و بسیاری از Workloadهای GPUمحور دارد و 12GB VRAM نیز نسبت به مدلهای 8GB فضای بیشتری برای اجرای مدل فراهم میکند.
مزیت اصلی این رده، رسیدن به یک GPU نسبتاً قدرتمند بدون ورود به قیمتهای بسیار بالای RTX 5080 و RTX 5090 است. با این حال، 12GB VRAM همچنان برای مدلهای بزرگتر محدودیت ایجاد میکند و اگر Local AI کاربرد اصلی دستگاه باشد، بهتر است کانفیگهای حداقل 32GB RAM را در نظر بگیرید.
مناسب برای: LLMهای متوسط، Coding، RAG، تولید تصویر و کاربری ترکیبی.
لپ تاپ MSI Vector 16 HX AI با RTX 5080؛ برای قدرت GPU بیشتر
لپ تاپ ام اس آی وکتور 16 اچ ایکس اِی آی
قیمت: حدود 670 میلیون تومان با گارانتی معتبر

اگر 12GB VRAM برای نیاز شما کافی نیست و در عین حال به اکوسیستم NVIDIA و قدرت پردازشی بالاتر نیاز دارید، RTX 5080 Laptop با 16GB GDDR7 یک پله بالاتر قرار میگیرد. این GPU با 7680 هسته CUDA برای تولید تصویر و ویدئو، LLMهای سنگینتر و سایر Workloadهای GPUمحور گزینه بسیار قدرتمندی است.
با این حال، تفاوت عملکرد آن با RTX 5070 Ti همیشه به اندازه اختلاف قیمت لپتاپها نیست. بنابراین RTX 5080 زمانی انتخاب منطقیتری است که واقعاً به 16GB VRAM و قدرت پردازشی بیشتر نیاز داشته باشید، نه صرفاً به دلیل قرار گرفتن آن در رده بالاتر.
مناسب برای: تولید تصویر و ویدئو، LLMهای متوسط و سنگینتر، CUDA و Workloadهای حرفهای GPUمحور.
لپ تاپ HP OMEN MAX 16 با RTX 5080؛ ترکیب متوازن و قدرتمند CPU و GPU
لپ تاپ اچ پی اومن مکس 16
قیمت: حدود 750 میلیون تومان با گارانتی معتبر

اگر به دنبال یک لپتاپ قدرتمند برای اجرای Local AI هستید، HP OMEN MAX 16 یکی از گزینههای جدی در رده RTX 5080 است. این مدل به پردازنده Core Ultra 9-275HX و 32 گیگابایت رم DDR5 در کنار RTX 5080 با 16GB حافظه GDDR7 مجهز شده و میتواند برای اجرای مدلهای زبانی بزرگتر، تولید تصویر و ویدئو و سایر Workloadهای سنگین GPUمحور عملکرد بسیار خوبی ارائه دهد.
نقطه قوت مهم این لپتاپ، ترکیب پردازنده 24 هستهای با RTX 5080 است؛ بنابراین علاوه بر کارهای کاملاً GPUمحور، برای Workloadهایی که بخشی از پردازش روی CPU انجام میشود نیز توان پردازشی بالایی در اختیار دارید. البته برای Local AI، محدودیت اصلی همچنان 16GB VRAM است و برای مدلهای بسیار بزرگتر یا اجرای مدلهای سنگین با Context طولانی، این ظرفیت میتواند زودتر از قدرت پردازشی GPU به مانع تبدیل شود. در چنین شرایطی، مدلهای مجهز به RTX 5090 با 24GB VRAM انتخاب مناسبتری هستند.
مناسب برای: اجرای LLMهای متوسط و سنگینتر، تولید تصویر و ویدئو، مدلهای AI مبتنی بر CUDA، توسعه و تست پروژههای هوش مصنوعی و Workloadهای حرفهای GPUمحور.
لپ تاپ ASUS ROG Zephyrus G16؛ قدرت بالا برای حملونقل آسانتر
لپ تاپ ایسوس آر او جی زفیروس جی 16
قیمت: حدود یک میلیارد تومان با گارانتی معتبر
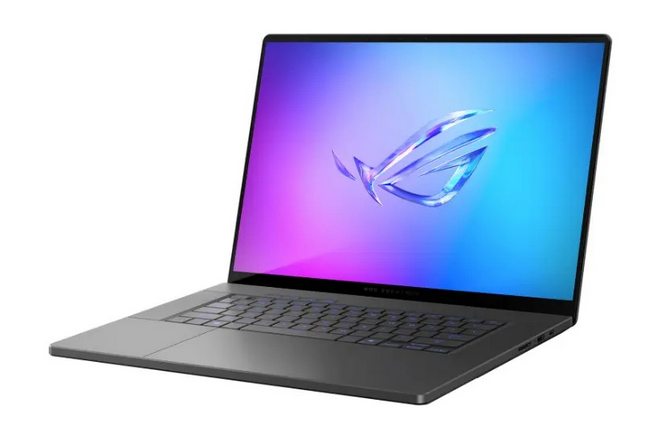
Zephyrus G16 با کانفیگهای RTX 5080 گزینهای متفاوت برای کاربری است که علاوه بر Local AI، قابلیت حمل و طراحی نسبتاً باریکتر را نیز جدی میگیرد. از نظر GPU، همان مزیت 16GB VRAM و اکوسیستم CUDA را در اختیار دارید، اما فرمفکتور دستگاه با لپتاپهای ضخیمتر و سنگینتر رده گیمینگ تفاوت دارد.
نکته مهم این است که برای بارهای پردازشی طولانی، نباید فقط نام GPU را مقایسه کرد. محدودیتهای حرارتی و توان مصرفی میتوانند باعث شوند یک لپتاپ ضخیمتر با همان RTX 5080 عملکرد پایدارتری ارائه کند.
مناسب برای: Local AI، بازی، تولید محتوا و کاربرانی که قابلیت حمل برایشان اهمیت دارد.
لپ تاپ Lenovo Legion Pro 7i با RTX 5090؛ حداکثر توان در اکوسیستم GeForce
لپ تاپ لنوو لژیون پرو 7آی
قیمت: حدود 730 میلیون تومان با گارانتی معتبر

RTX 5090 Laptop با 24GB GDDR7 و 10496 هسته CUDA بالاترین رده GeForce لپتاپی است و در این فهرست بیشترین VRAM را در میان GPUهای مجزای NVIDIA ارائه میکند. این ظرفیت برای مدلهای بزرگتر و Workflowهایی که روی 12 یا 16GB با محدودیت مواجه میشوند، یک مزیت واقعی است.
اما RTX 5090 را نباید صرفاً به دلیل قویتر بودن به همه کاربران پیشنهاد کرد. قیمت بسیار بالا، وزن و ابعاد برخی لپتاپهای این رده و کاهش ارزش خرید در استفادههای معمول باعث میشود این گزینه بیشتر برای کاربری تخصصی توجیه داشته باشد.
مناسب برای: LLMهای بزرگتر، تولید تصویر و ویدئوی سنگین، CUDA و Workloadهای حرفهای که واقعاً به 24GB VRAM نیاز دارند.
لپ تاپ ASUS ROG Flow Z13 با Ryzen AI Max+ 395
لپ تاپ ایسوس آر او جی فلو زد 13
قیمت: حدود 800 میلیون تومان با گارانتی معتبر
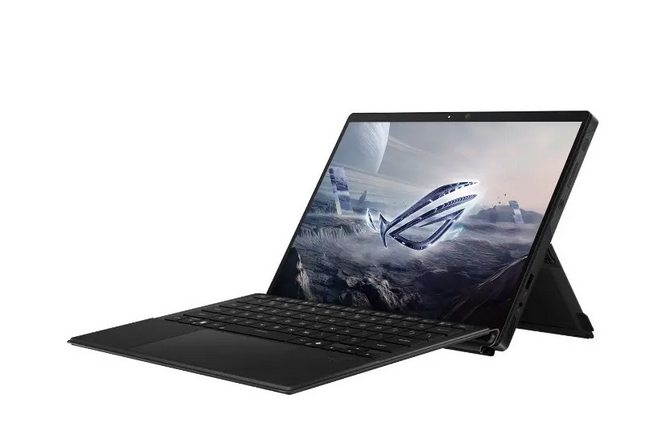
Flow Z13 یکی از متفاوتترین گزینههای این فهرست است. فارغ از طراحی هیبریدی آن، ترکیب Ryzen AI Max+ 395، پردازشگر گرافیکی Radeon 8060S و حافظه یکپارچه با ظرفیت بالا اجازه میدهد بخش بزرگی از حافظه 64 گیگابایتی رم سیستم در اختیار پردازنده گرافیکی نیز قرار گیرد. در نتیجه، این دستگاه میتواند مدلهایی را از نظر ظرفیت حافظه در نظر بگیرد که یک لپتاپ معمولی با 8، 12 یا حتی 16GB VRAM در آنها محدود میشود.
البته نباید این تصور را نیز داشته باشیم که این لپتاپ توانایی پردازش گرافیکی در حد یک RTX 5080 یا RTX 5090 دارد. نقطه قوت Flow Z13 ظرفیت حافظه و فرمفکتور کوچک است، نه رقابت مستقیم با GPUهای مجزای NVIDIA در سرعت پردازش. همچنین باید اشاره کنیم که حافظه نیز قابل ارتقا نیست، بنابراین انتخاب ظرفیت مناسب هنگام خرید اهمیت زیادی دارد.
مناسب برای: LLMهای بزرگتر، Workflowهای حافظهمحور، Offload و کاربرانی که قابلیت حمل اهمیت زیادی دارد.
لپ تاپ MacBook Pro با M5 Max؛ برای LLMهای حافظهمحور
لپ تاپ مک بوک پرو ام 5 مکس
قیمت: حدود 950 میلیون تومان با گارانتی معتبر

در لیست ما محصولات اپل نیز جایگاه ویژهای خواهند داشت. ویژگی اصلی آنها که امکان اجرای مدلهای زبانی بسیار بزرگ است، این لپتاپها به لطف استفاده از ساختار چیپست متفاوت آنها حاصل شده است. MacBook Pro مجهز به M5 Max با حافظه یکپارچه یا همان Unified Memory به CPU و GPU اجازه میدهد از یک فضای حافظه مشترک استفاده کنند و در کانفیگهای پرظرفیت، مقدار حافظه در دسترس برای مدل میتواند بسیار بیشتر از VRAM لپتاپهای معمولی باشد.
این ویژگی برای اجرای LLMهای بزرگ جذاب است، اما نباید ظرفیت حافظه را با سرعت پردازش یکی دانست. در بسیاری از Workloadهای GPUمحور، یک GeForce قدرتمند همچنان میتواند سرعت بالاتری ارائه کند. علاوه بر این، نبود CUDA باعث میشود سازگاری نرمافزار و Framework مورد استفاده پیش از خرید اهمیت ویژهای داشته باشد.
مناسب برای: LLMهای بزرگ، توسعه و تحقیق AI، RAG و کاربرانی که ظرفیت حافظه، قابلیت حمل و مصرف انرژی را در اولویت قرار میدهند.
برای Local AI چه سختافزاری در لپتاپ اهمیت دارد؟
انتخاب لپتاپ برای اجرای هوش مصنوعی محلی را نباید با همان معیارهایی انجام داد که برای یک لپتاپ عمومی یا حتی یک لپتاپ گیمینگ در نظر میگیریم. در بازی معمولاً قدرت GPU، نرخ فریم و کیفیت نمایشگر در مرکز توجه قرار دارند؛ اما در Local AI ابتدا باید پرسید مدل موردنظر در کدام حافظه قرار میگیرد، با چه شتابدهندهای اجرا میشود و این سختافزار با چه سرعتی میتواند آن را پردازش کند.
به همین دلیل، در ادامه به جای فهرست کردن انبوه مشخصات، روی عواملی تمرکز میکنیم که واقعاً در انتخاب لپتاپ مناسب برای این کاربرد اثرگذارند.
GPU، VRAM و قدرت پردازشی
اگر قرار باشد در انتخاب لپتاپ برای Local AI فقط یک قطعه را در اولویت قرار دهیم، آن قطعه معمولاً GPU است. بخش بزرگی از محاسبات موازی مدلهای هوش مصنوعی روی کارت گرافیک انجام میشود، اما قدرت پردازشی بهتنهایی معیار کافی نیست. مقدار VRAM هم اهمیت دارد و باید این دو را جداگانه بررسی کرد.
VRAM تعیین میکند چه مقدار از وزنهای مدل، کش و دادههای موردنیاز آن میتواند در حافظه گرافیکی قرار بگیرد. برای نمونه، در سری GeForce RTX 50 لپتاپی، RTX 5060 و RTX 5070 هر دو 8 گیگابایت حافظه GDDR7 دارند، در حالی که RTX 5080 به 16 گیگابایت و RTX 5090 به 24 گیگابایت مجهز شدهاند. توان مصرفی GPU نیز با توجه به مدل لپتاپ متفاوت است.
در جدول زیر میتوانید میزان حافظه بسیاری از کارتهای گرافیک رده لپتاپ فعلی بازار را ببینید:
| شرکت | کارت گرافیک لپتاپی | سال عرضه | ظرفیت VRAM | نوع حافظه |
|---|---|---|---|---|
| NVIDIA | GeForce RTX 5090 Laptop GPU | 2025 | 24GB | GDDR7 |
| NVIDIA | GeForce RTX 5080 Laptop GPU | 2025 | 16GB | GDDR7 |
| NVIDIA | GeForce RTX 5070 Ti Laptop GPU | 2025 | 12GB | GDDR7 |
| NVIDIA | GeForce RTX 5070 Laptop GPU | 2025 | 8GB | GDDR7 |
| NVIDIA | GeForce RTX 5060 Laptop GPU | 2025 | 8GB | GDDR7 |
| NVIDIA | GeForce RTX 5050 Laptop GPU | 2025 | 8GB | GDDR7 |
| NVIDIA | GeForce RTX 4090 Laptop GPU | 2023 | 16GB | GDDR6 |
| NVIDIA | GeForce RTX 4080 Laptop GPU | 2023 | 12GB | GDDR6 |
| NVIDIA | GeForce RTX 4070 Laptop GPU | 2023 | 8GB | GDDR6 |
| NVIDIA | GeForce RTX 4060 Laptop GPU | 2023 | 8GB | GDDR6 |
| NVIDIA | GeForce RTX 4050 Laptop GPU | 2023 | 6GB | GDDR6 |
| AMD | Radeon RX 7900M | 2023 | 16GB | GDDR6 |
| AMD | Radeon RX 7800M | 2024 | 12GB | GDDR6 |
| AMD | Radeon RX 7700S | 2023 | 8GB | GDDR6 |
| AMD | Radeon RX 7600M XT | 2023 | 8GB | GDDR6 |
| AMD | Radeon RX 7600M | 2023 | 8GB | GDDR6 |
| AMD | Radeon RX 7600S | 2023 | 8GB | GDDR6 |
البته VRAM بیشتر، بهخودیخود سرعت اجرای مدل را افزایش نمیدهد. اگر حافظه کافی برای قرار دادن مدل و دادههای موردنیاز آن وجود نداشته باشد، ممکن است اجرای مدل به استفاده از RAM سیستم یا روشهای دیگر Offload وابسته شود. در نظر داشته باشید که Offload یعنی بخشی از پردازش مدل که به دلیل کمبود حافظه یا منابع GPU، از VRAM به RAM یا پردازنده سیستم منتقل میشود و معمولاً سرعت اجرا را کاهش میدهد.
پس از فراهم شدن ظرفیت حافظه، توان پردازشی GPU، پهنای باند حافظه و بهینهسازی نرمافزاری در سرعت اجرا اهمیت پیدا میکنند. در عمل، اینکه یک مدل روی لپتاپ شما جا میشود، با اینکه بتوانید آن را سریع و روان اجرا کنید، دو موضوع جداگانه است.
مهمترین نکته در انتخاب سختافزار برای Local AI: «قابل اجرا بودن» با «سریع و روان اجرا شدن» مدل یکی نیست.
RAM، پردازنده (CPU) و SSD چقدر اهمیت دارند؟
همانطور که عنوان شد، RAM زمانی اهمیت بیشتری پیدا میکند که مدل بهطور کامل در VRAM جا نشود یا سیستم همزمان به حافظه بیشتری برای اجرای برنامهها و وظایف دیگر نیاز داشته باشد. برای یک لپتاپ مناسب شروع کار با Local AI، 16 گیگابایت RAM را میتوان حداقل قابلقبولی در نظر گرفت. با افزایش اندازه مدل و نیاز به اجرای همزمان ابزارهای مختلف، 32 گیگابایت انتخاب مناسبتری خواهد بود.
اگر هدف، اجرای مدلهای بزرگتر یا کار جدیتر با چند ابزار و مدل باشد، باید به رم بیشتر فکر کنیم که در دنیای واقعی لپتاپها منجر به افزایش سرسامآور قیمت محصول شده و شاید برای بسیاری از کاربران امکان خرید آن میسر نباشد. با این وجود یادآور میشویم که مقدار RAM موردنیاز را نمیتوان بدون در نظر گرفتن اندازه مدل، نوع کوانتایز، طول کانتکست و روش اجرا تعیین کرد. اگر بین خرید لپتاپی با RAM بیشتر و مدلی با GPU مشابه اما VRAM بالاتر مردد هستید، باید اندازه مدل و روش اجرای آن را هم در نظر بگیرید. حافظه سیستم بیشتر، محدودیت GPU را بهطور کامل برطرف نمیکند.
در همین رابطه بخوانید:
- بهترین پردازنده برای اجرای هوش مصنوعی چیست؟
- بهترین کارت گرافیک برای امور هوش مصنوعی و Local AI
- راهنمای خرید بهترین رم برای هوش مصنوعی؛ چه مقدار RAM برای Local AI نیاز است؟
CPU نیز در Local AI نقش مهمی دارد ولی نوع این نقش با عملکردی که در بیشتر مواقع، GPU در نظر میگیرد متفاوت است. پردازنده مرکزی سیستم حین عملیات پردازش هوش مصنوعی به صورت محلی (بهخصوص در اجرای مدلهای CPUمحور،)، پیشپردازش دادهها و مدیریت وظایف همزمان وارد کار میشود.
در سناریوهایی که بخش عمده محاسبات روی GPU انجام میشود، معمولاً GPU و حافظه آن در اولویت قرار میگیرند. بااینحال، پردازنده ضعیف میتواند در برخی بارهای کاری به گلوگاه تبدیل شود و اجرای همزمان برنامهها یا بعضی مراحل Offload را محدود کند. بنابراین صرفاً جدیدتر بودن CPU دلیل کافی برای انتخاب لپتاپ نیست؛ باید توان پردازشی آن را متناسب با نوع استفاده و سایر اجزای سیستم سنجید.
در مورد SSD، ظرفیت ذخیرهسازی برای کاربرانی که چند مدل هوش مصنوعی را روی لپتاپ نگهداری میکنند، اهمیت زیادی دارد. فایل مدلها، نسخههای کوانتایز و دادههای موردنیاز میتوانند فضای قابلتوجهی اشغال کنند. یک SSD یک یا دو ترابایتی، در مقایسه با حافظههای کوچکتر، امکان نگهداری مجموعه بزرگتری از مدلها و فایلها را فراهم میکند. سرعت SSD نیز در بارگذاری مدل و جابهجایی فایلها اثر دارد، اما نباید آن را با توان پردازشی GPU یا سرعت محاسبات مدل یکی دانست.
TGP و سیستم خنککننده را فراموش نکنید
یکی از تفاوتهای مهم لپتاپ با کامپیوتر دسکتاپ این است که GPU یک مدل مشخص ممکن است با محدودیت توان متفاوتی عرضه شود. برای مثال، NVIDIA برای RTX 5060 بازه 45 تا 100 وات و برای RTX 5090 بازه 95 تا 150 وات را اعلام میکند. همین تفاوت باعث میشود دو لپتاپ با GPU همنام، لزوماً عملکرد یکسانی نداشته باشند.
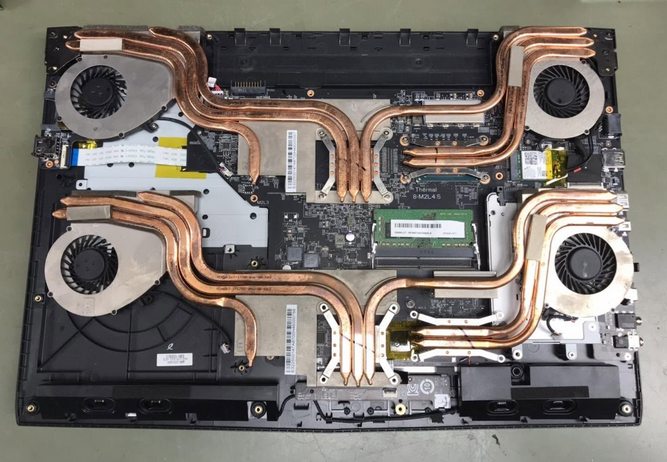
این موضوع در Local AI اهمیت بیشتری پیدا میکند؛ زیرا بار پردازشی مدل ممکن است برای مدت طولانی ادامه داشته باشد. در چنین شرایطی، توان خنککننده لپتاپ و توانایی آن برای حفظ فرکانس و مصرف موردنظر در بار مداوم، از یک نتیجه کوتاهمدت در بنچمارک مهمتر میشود.
VRAM یا حافظه یکپارچه؛ کدام برای Local AI بهتر است؟
تا چندی پیش، تقریباً تمام بحث درباره حافظه موردنیاز برای اجرای هوش مصنوعی در لپتاپ به VRAM کارت گرافیک محدود میشد؛ اما معماریهای جدیدتر این معادله را تغییر دادهاند. در لپتاپهای مجهز به GPU مجزا، کارت گرافیک حافظه اختصاصی خود را دارد و ظرفیت VRAM یکی از محدودیتهای اصلی فضای حافظه در دسترس برای پردازش گرافیکی است. در مقابل، برخی پلتفرمهای جدید مانند Apple Silicon و AMD Ryzen AI Max از حافظه یکپارچه یا Unified Memory استفاده میکنند که CPU و GPU به یک فضای حافظه مشترک دسترسی دارند.
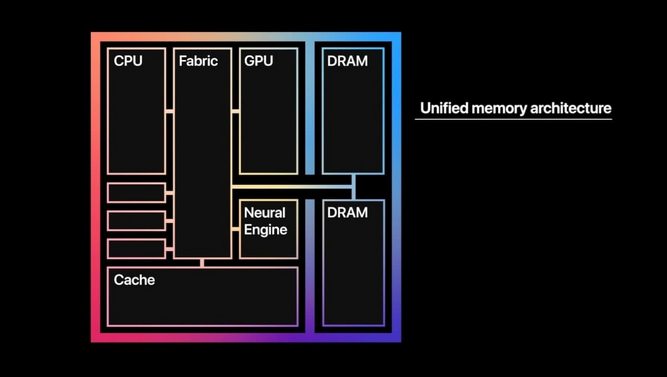
با این حال، Variable Graphics Memory یا Unified Memory را نباید معادل VRAM اختصاصی یک GPU مجزا در نظر گرفت. مزیت اصلی حافظه یکپارچه، افزایش ظرفیت حافظه قابل دسترس برای شتابدهنده است؛ اما پهنای باند، معماری GPU، مسیرهای حافظه و پشتیبانی نرمافزاری همچنان تأثیر مستقیمی بر سرعت واقعی inference دارند.
مزیت مهم این رویکرد، امکان ارائه ظرفیت حافظه بسیار بالا در یک سیستم لپتاپی است. برای مثال، MacBook Proهای مجهز به M5 Max را میتوان با حداکثر 128GB حافظه Unified و تا 614GB/s پهنای باند حافظه پیکربندی کرد. در سمت AMD نیز Ryzen AI Max+ 395 از حافظه LPDDR5x با ظرفیت حداکثر 128GB استفاده میکند و AMD امکان اختصاص بخش بزرگی از این حافظه به پردازش گرافیکی را فراهم کرده است؛ در پیکربندی 128GB، حداکثر 96GB میتواند بهعنوان حافظه گرافیکی اختصاص یابد.
این ظرفیت بالا برای Local AI اهمیت ویژهای دارد، زیرا در بعضی سناریوها امکان اجرای مدلهایی را فراهم میکند که در VRAM یک GPU مجزا جا نمیشوند. با این حال، نباید این معماریها را صرفاً با یک عدد مقایسه کرد؛ 96 یا 128GB حافظه مشترک به این معنی نیست که یک GPU یکپارچه از نظر سرعت پردازش با یک GPU مجزای قدرتمند دارای همان مقدار VRAM برابری میکند.
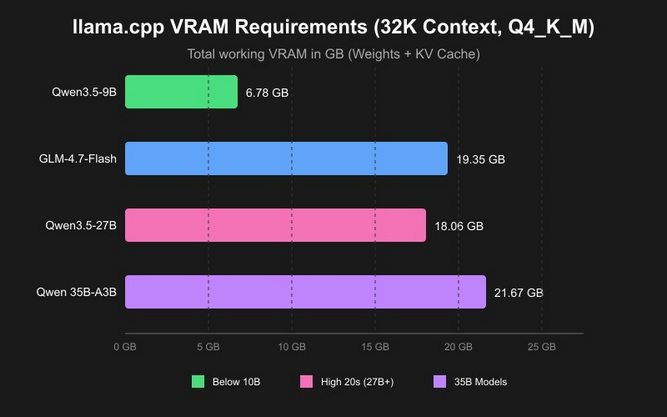
در نتیجه، هنگام خرید لپتاپ برای Local AI باید دو رویکرد را از هم جدا کرد: آیا حافظه کافی برای مدل موردنظر وجود دارد؟ و این مدل با چه سرعتی میتواند اجرا شود؟
پاسخ سؤال اول بیشتر به ظرفیت و معماری حافظه وابسته است، در حالی که پاسخ سؤال دوم به قدرت شتابدهنده، پهنای باند حافظه، توان مصرفی و پشتیبانی نرمافزاری بستگی دارد. به همین دلیل، یک لپتاپ با گرافیک مجزا NVIDIA ولی VRAM کمتر میتواند برای کاربری که سرعت بالای inference یا سازگاری با CUDA برایش اهمیت دارد انتخاب بهتری باشد، در حالی که سیستمی با Unified Memory بیشتر ممکن است برای کاربری که اولویت اصلیاش اجرای مدلهای بزرگتر است، منطقیتر باشد.
ظرفیت حافظه، محدودیت واقعی لپتاپها
در لپتاپهای موجود در بازار، افزایش VRAM (یعنی کارت گرافیک قویتر و ردهبالاتر) معمولاً با افزایش شدید قیمت همراه است. مدلهای مجهز به 16 گیگابایت VRAM یا بیشتر عمدتاً در رده لپتاپهای گیمینگ و حرفهای گرانقیمت قرار میگیرند و نباید آنها را گزینهای معمول برای همه خریداران دانست. از طرف دیگر، لپتاپهایی با حافظه Unified بسیار زیاد نیز انتخابهای محدودی هستند و معمولاً قیمت بالایی دارند.
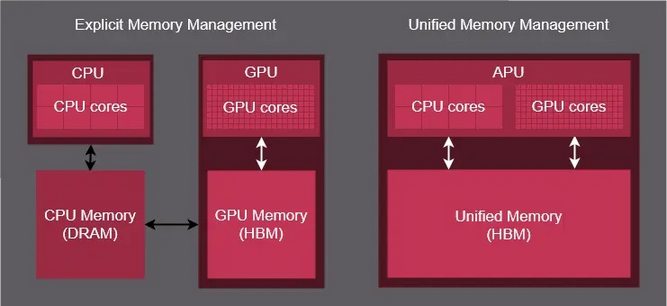
به همین دلیل، در عمل باید بهجای دنبال کردن بیشترین ظرفیت حافظه، ابتدا مدلهایی را مشخص کنید که قصد اجرای آنها را دارید. برای بسیاری از کاربران، یک لپتاپ با 8 یا 12 گیگابایت VRAM و مدلهای کوانتایزشده کوچکتر انتخاب واقعبینانهتری است. رفتن به سراغ 16 گیگابایت VRAM یا بیشتر زمانی توجیه پیدا میکند که اجرای مدلهای بزرگتر، استفاده از Context طولانی یا کاهش وابستگی به Offload برایتان اهمیت داشته باشد.
ظرفیت حافظه بهتنهایی سرعت اجرای مدل را تعیین نمیکند. وقتی مدل بهطور کامل در حافظه سریع GPU جا میگیرد، قدرت پردازشی GPU و پهنای باند حافظه نقش مهمی در سرعت دارند. اگر بخشی از مدل به RAM منتقل شود، اجرای آن همچنان ممکن است، اما انتقال داده میان حافظه سیستم و GPU میتواند سرعت را کاهش دهد. در نتیجه، «قابل اجرا بودن» با «اجرای روان و سریع» تفاوت دارد.
KV Cache؛ حافظهای که با طول Context افزایش پیدا میکند
KV Cache حافظهای موقت است که مدل زبانی برای نگهداری اطلاعات پردازششده متن و استفاده از آن هنگام تولید پاسخ به کار میگیرد. هرچه طول Context یا تعداد درخواستهای همزمان بیشتر باشد، مقدار حافظه موردنیاز برای KV Cache نیز معمولاً افزایش پیدا میکند.
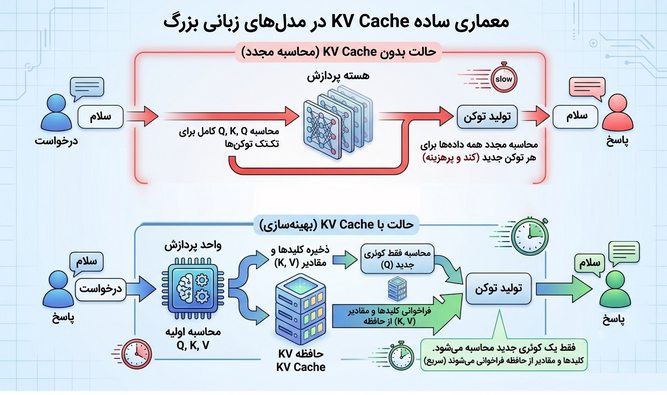
بنابراین ممکن است وزنهای یک مدل در VRAM لپتاپ جا شوند، اما هنگام استفاده از Context طولانی یا اجرای چند درخواست همزمان، فضای آزاد حافظه کافی نباشد. به همین دلیل، ظرفیت VRAM را نباید دقیقاً برابر با حجم فایل مدل در نظر گرفت و باید مقداری فضا برای KV Cache و سایر نیازهای اجرایی باقی بماند.
در نهایت، برای خرید لپتاپ Local AI باید بین ظرفیت حافظه، سرعت اجرای مدل و قیمت دستگاه تعادل برقرار کرد. لپتاپ گرانتر با VRAM بیشتر لزوماً برای همه کاربران انتخاب مناسبتری نیست؛ همانطور که ارزانتر بودن یک مدل با حافظه محدودتر، در صورت ناتوانی در اجرای مدل موردنظر، مزیت محسوب نمیشود.
آیا TOPS و NPU برای Local AI مهماند؟
با رواج عبارتهایی مانند AI PC و Copilot+ PC، کمیتی موسوم به TOPS به یکی از مشخصاتی تبدیل شده که در معرفی لپتاپهای جدید زیاد دیده میشود. TOPS مخفف «تریلیون عملیات بر ثانیه» است و بهصورت کلی توان محاسباتی نظری یک شتابدهنده را نشان میدهد.
میزان پارامتر TOPS یک پردازشگر بهتنهایی نشان نمیدهد یک مدل هوش مصنوعی با چه سرعتی روی سیستم یا لپتاپ اجرا خواهد شد؛ زیرا نوع شتابدهنده، دقت محاسبات، معماری و روش محاسبه TOPS میتواند میان محصولات مختلف متفاوت باشد. بنابراین مقایسه مستقیم TOPS یک NPU با GPU یا حتی مقایسه اعداد اعلامشده از سوی سازندگان مختلف، بدون بررسی شرایط اندازهگیری، میتواند گمراهکننده باشد.
در همین رابطه بخوانید:
- هر آنچه باید درباره TOPS بدانید؛ از صفر تا صد قدرت پردازش AI پردازندهها
NPU یا واحد پردازش عصبی، یک شتابدهنده تخصصی برای اجرای برخی وظایف AI با مصرف انرژی پایین است و بیشتر برای پردازشهای مداوم و سبکتر روی خود دستگاه، مانند برخی قابلیتهای هوش مصنوعی سیستمعامل و برنامههای سازگار، اهمیت پیدا میکند.
وجود NPU برای یک لپتاپ مزیت محسوب میشود، اما به این معنی نیست که جای GPU قدرتمند را برای تمام کاربردهای Local AI میگیرد. برای Workloadهای سنگین مانند بسیاری از LLMها، تولید تصویر و ویدئو و سایر پردازشهای GPUمحور، قدرت GPU و حافظه قابل استفاده برای مدل معمولاً اهمیت بسیار بیشتری دارد.
از طرف دیگر، TOPS را نباید کاملاً بیاهمیت دانست. اگر هدف شما استفاده از قابلیتهای AI کممصرف سیستمعامل، پردازشهای سبک روی دستگاه یا برنامههایی باشد که مشخصاً از NPU پشتیبانی میکنند، توان NPU میتواند یک معیار مفید باشد. برنامههای عمومی و برنامههای اختصاصی شرکتها که امور شما را راحتتر میکند از این دسته ابزارها هستند که وابستگی بیشتر به پردازش عصبی دارند.
اما اگر هدف اصلی شما اجرای مدلهای Local AI است، صرفاً دنبال کردن عدد بالاتر TOPS تصمیم درستی نیست؛ یک لپتاپ با NPU قدرتمند الزاماً برای اجرای LLM یا تولید تصویر بهتر از لپتاپی با NPU ضعیفتر نیست.
برای اجرای مدل و کاربرد موردنظرمان چه لپتاپی بخریم؟
فارغ از موضوع سرعت و امکان اجرای مدل که در بخشهای قبلی به صورت مفصل در مورد آنها صحبت کردیم، این نکته نیز برای خرید لپ تاپ مناسب هوش مصنوعی باید در نظر گرفته شود که همیشه نمیتوان به لپ تاپی با VRAM بالا رسید. اما توجه به نکات ریز انتخاب سختافزار کمک میکند که برای مدل مد نظر خودمان، بهترین انتخاب را داشته باشیم.
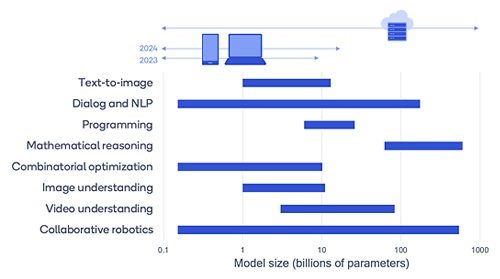
مدلهای کوچک 3B تا 8B
برای مدلهای سبک مورد استفاده در چت، دستیار شخصی، Coding Assistant و RAG ساده، معمولاً نیازی به لپتاپ ردهبالا ندارید. مدلهای Quantized در این محدوده حتی روی CPU و RAM سیستم نیز قابل اجرا هستند، هرچند استفاده از GPU مجزا میتواند سرعت پاسخگویی را به شکل محسوسی افزایش دهد.

برای چنین کاربردی، 16GB RAM و در صورت استفاده از GPU، 8GB VRAM نقطه شروع مناسبی است. اگر میخواهید لپتاپ برای مدلهای آینده نیز فضای بیشتری داشته باشد، 32GB RAM و 12GB VRAM انتخاب آیندهنگرانهتری خواهد بود. این سطح سختافزار برای یادگیری Local AI، چتبات شخصی، Coding و RAG سبک کفایت میکند.
مدلهای 10B تا 14B
با ورود به مدلهای 10B تا 14B، ظرفیت حافظه اهمیت بیشتری پیدا میکند. یک مدل Quantized حدود 12B یا 14B الزاماً به GPU مجزا نیاز ندارد و میتواند با تکیه بر RAM سیستم اجرا شود، اما اگر سرعت پاسخگویی برایتان اهمیت دارد، GPU مجهز به 12 تا 16GB VRAM انتخاب مناسبتری خواهد بود. افزایش طول Context یا اجرای همزمان برنامههای دیگر نیز میتواند نیاز حافظه را افزایش دهد.
برای اجرای CPUمحور، بهتر است حداقل 16 تا 32GB RAM در اختیار داشته باشید و برای اجرای سریعتر روی GPU، 32GB RAM در کنار 12 تا 16GB VRAM انتخاب متعادلتری است. در میان لپتاپهای این رده، RTX 5070 Ti همراه با 32GB RAM میتواند گزینهای متعادل برای LLMهای متوسط، Coding Assistant، RAG حرفهایتر و استفاده روزمره از مدلهای محلی باشد.
مدلهای 20B تا 32B
در مدلهای 20B تا 32B، تفاوت میان «مدل اجرا میشود» و «مدل با سرعت مناسب اجرا میشود» اهمیت بسیار بیشتری پیدا میکند. یک مدل 30B یا 32B با Quantization چهار بیتی میتواند بخش قابلتوجهی از حافظه را مصرف کند و لپتاپهای مجهز به 16GB VRAM معمولاً برای اجرای کامل چنین مدلهایی ایدهآل نیستند. امکان Offload به RAM وجود دارد، اما در این حالت سرعت اجرا به نحوه تقسیم بار میان حافظهها و شرایط سیستم وابسته خواهد بود.
برای این سطح از استفاده، حداقل 32GB RAM و برای کاربری جدیتر 64GB RAM پیشنهاد میشود. اگر هدف، اجرای سریع مدل روی GPU است، بهتر است به سراغ GPUهای دارای 24GB VRAM یا راهکارهای حافظهمحور با ظرفیت بالاتر بروید. این سطح بیشتر برای توسعه حرفهای، مدلهای بزرگتر و RAG سنگین مناسب است و میتواند وابستگی به Offload را کاهش دهد.
اگر اجرای مداوم مدلهای 20B تا 32B هدف اصلی شماست، مقایسه لپتاپ با دسکتاپ نیز اهمیت پیدا میکند؛ زیرا ممکن است هزینه بیشتر برای یک لپتاپ ردهبالا، افزایش عملکردی متناسب با قیمت ایجاد نکند.
مدلهای بسیار بزرگ مانند 70B
برای مدلهای 70B، دیگر نمیتوان روی لپتاپهای معمولی با 16 یا 24GB VRAM حساب کرد. حتی با Quantization چهار بیتی، وزنهای مدل به حدود 40GB یا بیشتر حافظه نیاز دارند و Context و سربار Runtime نیز به این مقدار اضافه میشوند.
در چنین شرایطی، سیستمهای مجهز به Unified Memory با ظرفیت بالا مسیر متفاوتی پیش روی کاربر قرار میدهند. لپتاپهایی مانند MacBook Pro با حافظه Unified بالا یا دستگاههای مبتنی بر Ryzen AI Max میتوانند از نظر ظرفیت حافظه امکان اجرای مدلهای بزرگتر را فراهم کنند. با این حال، ظرفیت بالاتر حافظه بهتنهایی به معنی سرعت بیشتر نیست و نباید چنین سیستمهایی را صرفاً به دلیل داشتن 64، 96 یا 128GB حافظه، سریعتر از یک GPU مجزای قدرتمند NVIDIA دانست.
برای سیستمهای حافظهمحور، 64GB حافظه یا بیشتر نقطه شروع منطقیتری است؛ اما اگر سرعت اجرای مدل اهمیت زیادی دارد، معمولاً دسکتاپ یا Workstation با ظرفیت بالاتر حافظه شتابدهنده انتخاب منطقیتری خواهد بود. این سطح از سختافزار عمدتاً برای کاربران تخصصی مناسب است که مشخصاً به اجرای مدلهای بسیار بزرگ بهصورت محلی نیاز دارند.
تولید تصویر و ویدئو با AI
در ابزارهایی مانند Stable Diffusion، FLUX و ComfyUI و بسیاری از Workflowهای تولید تصویر و ویدئو، اولویت بیشتر با GPU، VRAM و سازگاری نرمافزاری است. در این کاربرد، افزایش RAM سیستم لزوماً نمیتواند جای یک GPU قدرتمندتر را بگیرد.
برای کاربری جدی، 12GB VRAM را میتوان نقطه شروع مناسبی دانست و برای Workflowهای سنگینتر بهتر است سراغ 16GB یا بیشتر بروید. در کنار آن، حداقل 32GB RAM توصیه میشود. در این رده، RTX 5070 Ti انتخابی متعادل، RTX 5080 گزینهای قدرتمندتر و RTX 5090 انتخابی حداکثری است که بیشتر زمانی توجیه دارد که واقعاً به ظرفیت بالاتر حافظه و توان پردازشی آن نیاز داشته باشید.
این پیکربندیها برای تولید تصویر و ویدئو، Stable Diffusion، FLUX، ComfyUI، LoRA و سایر Workflowهای GPUمحور مناسب هستند.
Coding Assistant، RAG و دستیار شخصی
برای Coding Assistant، RAG و دستیارهای شخصی معمولاً نیازی به قدرتمندترین GPU بازار ندارید. یک مدل Quantized در محدوده 7B تا 14B میتواند تعادل مناسبی میان کیفیت، سرعت و مصرف حافظه ایجاد کند.
در این سناریو، RAM سیستم اهمیت ویژهای پیدا میکند؛ زیرا ممکن است همزمان IDE، مرورگر، دیتابیس، ابزارهای توسعه و مدل AI در حال اجرا باشند. بنابراین در بسیاری از موارد، ارتقای RAM میتواند به اندازه ارتقای GPU روی تجربه کاربر تأثیر داشته باشد.
برای این نوع استفاده، 32GB RAM در کنار 12 تا 16GB VRAM انتخاب مناسبی است و اگر Workflow سنگینتری دارید یا چند سرویس را بهصورت همزمان اجرا میکنید، 64GB RAM ارزش بیشتری پیدا میکند. یک لپتاپ مجهز به RTX 5070 Ti و 32GB RAM میتواند انتخاب متعادلی برای برنامهنویسی، RAG، دستیار شخصی، پژوهش و کاربرانی باشد که میخواهند AI را بهصورت دائمی و محلی اجرا کنند.
جدول جامع برای تصمیمگیری بر اساس مدل و کاربرد
|
هدف / اندازه مدل |
نمونه مدل AI |
RAM پیشنهادی |
VRAM / حافظه شتابدهنده پیشنهادی |
مسیر مناسب |
|---|---|---|---|---|
| Multimodal بزرگ | Llama 4 Scout و مدلهای مشابه | 64–128GB+ | 24GB+ | Unified Memory بالا یا GPU با VRAM زیاد |
| LLM بسیار بزرگ | gpt-oss-120b | 64–128GB+ | 48GB+ در صورت اجرای GPUمحور | Flow Z13، MacBook Pro، دسکتاپ یا Workstation |
| LLM بسیار بزرگ، 70B+ | مدلهای 70B و بالاتر | 64–128GB+ | 48GB+ در اجرای GPUمحور | Unified Memory بالا، دسکتاپ یا Workstation |
| تولید تصویر و Workflow سنگین | FLUX و Workflowهای پیچیده | 64GB | 16–24GB | RTX 5080/5090 |
| تولید تصویر | Stable Diffusion، FLUX | 32GB | 12–16GB+ | RTX 5070 Ti یا RTX 5080 |
| Coding سنگین | Qwen3-Coder 30B | 64GB+ | 24GB+ | RTX 5080/5090 یا سیستم حافظهمحور |
| LLM متوسط تا بزرگ، 20B تا 32B | Qwen3-32B | 32–64GB | 24GB+ | GPU ردهبالا یا Unified Memory بالا |
| Reasoning محلی | gpt-oss-20b | 32GB+ | 12–16GB+ | RTX 5070 Ti/5080 یا حافظه Unified بالا |
| LLM متوسط، 10B تا 14B | مدلهای 12B–14B | 16–32GB | 12–16GB | RTX 5070 Ti یا RTX 5080 |
| چت و Coding سبک، 3B تا 8B | مدلهای 7B–8B | 16–32GB | 8–12GB | لپتاپ میانرده، مانند RTX 5060/5070 |
| چت و Coding سبُک ابتدایی | مدلهای تا 12B | حداقل 16GB | اگر کارت گرافیک باشد بهتر ولی اگر نبود، iGPU مدل 2022 به بالا | آشنایی پایه با Local AI – نکته مهم: این پیشنهاد فقط برای اجرای مدلهاست نه سرعت پاسخ بالا |
توجه داشته باشید که اعداد مندرج در این جدول، نقطه شروع هستند، نه حداقلهای قطعی.
بنابراین اگر فقط یک اصل را از این بخش به خاطر میسپارید، این باشد:
ابتدا مشخص کنید چه مدلی را برای چه کاری میخواهید اجرا کنید، سپس ظرفیت حافظه موردنیاز را تعیین کنید و بعد سراغ قدرت GPU بروید. خرید لپتاپ صرفاً بر اساس قویترین GPU یا بیشترین RAM، بدون توجه به Workload واقعی، میتواند به پرداخت هزینهای منجر شود که در عمل استفادهای از آن نخواهید داشت.
بهترین لپتاپهای نسل قبل برای Local AI
در انتخاب لپتاپ برای Local AI، رسیدن به نسل جدید لزوماً به معنی رسیدن به انتخاب بهتر نیست. تفاوت میان نسلهای GPU بیشتر زمانی اهمیت پیدا میکند که با ظرفیت VRAM، قدرت واقعی GPU و قیمت دستگاه کنار هم دیده شود. به همین دلیل، یک لپتاپ نسل قبل با RTX 4080 یا RTX 4090 میتواند در صورت قیمت مناسب، انتخاب منطقیتری از یک مدل جدیدتر با GPU ضعیفتر باشد. این موضوع در بازار ایران اهمیت بیشتری دارد؛ جایی که موجودی لپتاپهای جدید محدودتر و قیمت برخی مدلهای ردهبالا بسیار بالا است.
لپتاپهای نسل قبل؛ چه زمانی ارزش خرید دارند؟
در Local AI، قدیمیتر بودن یک لپتاپ لزوماً به معنی انتخاب ضعیفتر نیست. در بسیاری از موارد، GPUهای نسل قبل همچنان ظرفیت VRAM مناسبی دارند و اگر لپتاپ با قیمت پایینتری نسبت به مدل جدید مشابه عرضه شود، میتواند ارزش خرید بالایی داشته باشد.
برای مثال، RTX 4090 Laptop با 16GB VRAM، RTX 4080 Laptop با 12GB و RTX 3080 Ti Laptop با 16GB VRAM همچنان برای بسیاری از کاربردهای Local AI قابل استفادهاند. بنابراین هنگام خرید دستدوم یا لپتاپهای باقیمانده از نسل قبل، بهتر است به جای تمرکز صرف بر نسل GPU، ظرفیت VRAM، قدرت واقعی GPU، وضعیت خنککننده و قیمت دستگاه را بررسی کنید.
البته نسل قبل زمانی انتخاب منطقی است که اختلاف قیمت آن با نسل جدید به اندازه کافی زیاد باشد. اگر یک لپتاپ قدیمی با قیمت نزدیک به مدل جدیدتر فروخته شود، معمولاً مزیت خاصی برای پذیرش سختافزار قدیمیتر وجود ندارد؛ مگر اینکه مدل قدیمی ظرفیت VRAM بیشتری داشته باشد یا برای نیاز مشخص کاربر مناسبتر باشد.
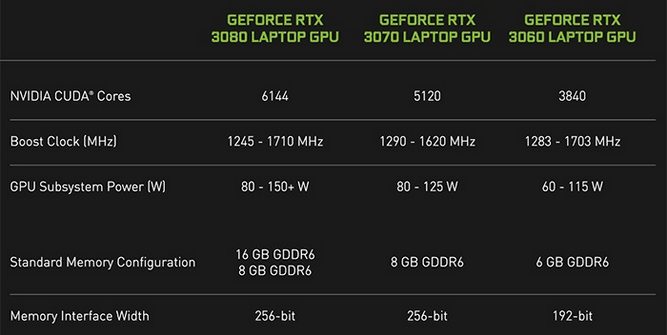
در خرید لپتاپ نسل قبل، وضعیت خود دستگاه نیز اهمیت زیادی دارد. سلامت باتری، عملکرد سیستم خنککننده، میزان استهلاک، سلامت GPU و CPU و امکان ارتقای RAM و SSD را بررسی کنید. این موارد در یک لپتاپ چندساله میتوانند به اندازه مشخصات اولیه دستگاه مهم باشند.
اگر یک لپتاپ نسل قبل، GPU همچنان VRAM کافی برای مدل موردنظر شما دارد و دستگاه با اختلاف قیمت قابل توجهی ارزانتر از نسل جدید عرضه میشود، میتواند یکی از بهترین گزینههای اقتصادی برای Local AI باشد.
هنگام خرید مدل نسل قبل یا دستدوم چه چیزهایی را بررسی کنیم؟
در لپتاپهای قدیمیتر، کیفیت نمونهای که میخرید به اندازه مدل اهمیت پیدا میکند. قبل از خرید، سلامت GPU و CPU، دمای قطعات در بار طولانی، عملکرد فنها، سلامت باتری، وضعیت نمایشگر و سابقه تعمیر را بررسی کنید. همچنین اگر دستگاه دستدوم است، وجود امکان ارتقای RAM و SSD میتواند ارزش خرید آن را افزایش دهد؛ زیرا در Local AI ممکن است بعداً به حافظه سیستم بیشتری نیاز پیدا کنید.
در نهایت باید گفت، لپتاپ نسل قبل زمانی برای Local AI جذاب است که «قدرت و ظرفیت حافظهای که دریافت میکنید» نسبت به پولی که میپردازید، بهتر از گزینههای جدید بازار باشد. بنابراین مدلهایی مانند RTX 4080 و RTX 4090 نسل قبل همچنان ارزش بررسی دارند، اما RTX 3080 Ti و مدلهای قدیمیتر فقط در صورت اختلاف قیمت محسوس و سلامت مناسب دستگاه میتوانند به انتخاب قابل توصیه تبدیل شوند.
چه لپتاپهایی برای Local AI ارزش خرید کمتری دارند؟
برای Local AI، گرانتر یا جدیدتر بودن لپتاپ لزوماً به معنی انتخاب بهتر نیست. اگر هدف اصلی شما اجرای مدلهای محلی است، پرداخت هزینه بالا برای لپتاپی که GPU آن فقط 8GB VRAM دارد، معمولاً توجیه چندانی ندارد؛ مگر اینکه مدلهای سبکتر برایتان کافی باشد. همچنین افزایش RAM سیستم از 32 به 64GB نمیتواند کمبود VRAM را بهطور کامل جبران کند و در بسیاری از سناریوها، یک GPU با VRAM بیشتر انتخاب مفیدتری خواهد بود.
از طرف دیگر، نباید صرفاً به برچسبهایی مانند AI PC، NPU یا TOPS بالا دل ببندید. این مشخصات برای برخی قابلیتهای هوش مصنوعی روی دستگاه مفیدند، اما معیار مستقیمی برای سرعت اجرای LLM، تولید تصویر یا سایر Workloadهای سنگین Local AI نیستند. در نهایت، مدل موردنظر، حافظه قابل استفاده، قدرت واقعی شتابدهنده، سازگاری نرمافزاری و قیمت دستگاه باید مبنای تصمیمگیری باشند.
نکته دیگر این است که اگر فقط هدف شما Local AI باشد باید وزن پارامترهای خاص دیگر مانند نمایشگر بسیار گران مانند پنلهای OLED یا miniLED را کمتر کنید. همچنین امکانات جانبی غیرلازم که بیشتر ابعاد گیمینگ را هدف گرفتهاند نیز به رقم برچسب قیمت لپتاپ اضافه میکنند که بهتر است به دنبال گزینههایی باشید که به جای این موارد، تمرکز را روی سختافزار پیشرفتهتر و ردهبالاتر گذاشتهاند.
جمعبندی؛ برای Local AI کدام لپتاپ را بخریم؟
برای انتخاب لپتاپ مناسب Local AI نباید صرفاً به قدرت پردازنده و GPU نگاه کرد. معیار اصلی، تعادل میان مدل و نرمافزار موردنظر، ظرفیت VRAM و RAM، توان GPU، قابلیت خنککنندگی، امکان ارتقا، سازگاری نرمافزاری و قیمت واقعی دستگاه است. جدیدتر یا گرانتر بودن لپتاپ بهتنهایی به معنی انتخاب بهتر نیست.
اگر هدف اصلی شما اجرای LLMهای محلی و مدلهای متوسط است، GPU مجزا با حداقل حدود 12GB VRAM نقطه شروع مناسبی است و مدلهای 16GB فضای بیشتری برای مدلهای بزرگتر و استفاده آینده فراهم میکنند. برای سرعت بالا، تولید تصویر، CUDA و سایر Workloadهای GPUمحور، معمولاً گزینههای NVIDIA انتخاب منطقیتری هستند؛ البته قیمت واقعی لپتاپ و نسلهای قبلی باید در کنار یکدیگر مقایسه شوند.
در مقابل، اگر اولویت شما اجرای مدلهای بزرگتر و دسترسی به ظرفیت حافظه بیشتر است، لپتاپهای مبتنی بر Unified Memory مانند MacBook Pro یا محصولات مجهز به Ryzen AI Max+ 395 میتوانند گزینههای متفاوتی باشند. با این حال، ظرفیت بیشتر حافظه الزاماً به معنی سرعت بالاتر نیست و سازگاری نرمافزاری و قیمت باید در مقایسه با گزینههای NVIDIA موجود در بازار ایران در نظر گرفته شود.
در نهایت، لپتاپهای نسل قبل را هم نادیده نگیرید. مدلهایی مانند RTX 4080 با 12GB، RTX 4090 با 16GB و حتی RTX 3080 Ti، اگر با قیمت مناسب و شرایط فنی مطلوب پیدا شوند، ممکن است برای Local AI ارزش خرید بیشتری از یک لپتاپ جدیدتر با تنها 8GB VRAM داشته باشند.
در نهایت، پیشنهادهای این راهنما را میتوان در چند جمله خلاصه کرد:
|
نیاز اصلی شما |
مسیر پیشنهادی |
|---|---|
|
LLMهای سبک و متوسط |
لپتاپ NVIDIA میانرده با VRAM مناسب |
|
LLMهای بزرگتر |
GPU با VRAM بیشتر یا Unified Memory با ظرفیت بالا |
|
تولید تصویر و Workloadهای CUDA |
حتماً انویدیا و محصولات با حافظه و قدرت بالا |
|
حداکثر سرعت پردازش GPU |
NVIDIA ردهبالا |
|
اولویت ظرفیت حافظه |
Unified Memory یا GPU با VRAM بالا |
|
بودجه محدود |
لپتاپ نسل قبل یا مدل جدید اقتصادی |
|
بهترین ارزش خرید |
مقایسه همزمان نسل جدید، نسل قبل و در صورت توجیه دستدوم |
|
بودجه بسیار بالا |
قویترین گزینهای که واقعاً به آن نیاز دارید، نه لزوماً گرانترین مدل |
سؤالات متداول
آیا برای Local AI حتماً GPU مجزا لازم است؟
خیر. مدلهای کوچکتر روی CPU یا iGPU هم قابل اجرا هستند، اما برای LLMهای بزرگ و تولید تصویر، GPU مجزا معمولاً هم سرعت و هم سازگاری بهتری دارد.
برای Local AI مهمتر است VRAM بیشتر داشته باشیم یا GPU سریعتر؟
ابتدا باید مدل در حافظه جا شود؛ بعد سرعت اجرا اهمیت پیدا میکند. VRAM بیشتر سقف مدلهای قابل اجرا را بالا میبرد، GPU سریعتر همان مدل را سریعتر اجرا میکند.
8GB VRAM برای Local AI کافی است؟
برای مدلهای سبک بله، اما برای خریدی که قرار است چند سال دوام داشته باشد، 12GB یا 16GB فضای بسیار بهتری برای مدلهای بزرگتر فراهم میکند.
آیا 64GB RAM جای 16GB VRAM را میگیرد؟
خیر. میتواند با Offload امکان اجرای مدل را فراهم کند، اما حافظه سیستم معمولاً بسیار کندتر از VRAM برای این کار است.
آیا 128GB Unified Memory برابر با 128GB VRAM است؟
خیر. ظرفیت حافظه مشابه نیست. Unified Memory میتواند مدل بسیار بزرگتری را در اختیار پردازش قرار دهد، اما سرعت پردازش GPU مستقل با آن یکی نیست.
چطور بفهمیم لپتاپ من برای اجرای LLM مناسب است؟
سه چیز را بررسی کنید: اندازه مدل، نوع Quantization و Context موردنیاز. فقط تعداد پارامترهای مدل کافی نیست.
چرا یک مدل 120B گاهی روی سختافزار ضعیفتر هم قابل اجراست؟
چون تعداد پارامترهای فعال، Quantization و معماری مدل مهماند. مثلاً gpt-oss-120b با 116.8B پارامتر کل، به دلیل MXFP4 و MoE برای اجرا در حدود 60.8GiB checkpoint طراحی شده است.
آیا RTX 5090 Laptop همیشه بهترین انتخاب است؟
خیر. بهترین گزینه برای کسی است که واقعاً به 24GB VRAM و قدرت بالای GPU نیاز دارد. برای کاربر حافظهمحور ممکن است 128GB Unified Memory منطقیتر باشد.
MacBook برای Local AI بهتر است یا لپ تاپ ویندوزی؟
برای مدلهای حافظهمحور و کسانی که به پردازشهای بر پایه هستههای CUDA نیاز ندارند، MacBook میتواند جذاب باشد. برای CUDA، تولید تصویر و بسیاری از Workloadهای GPUمحور، NVIDIA معمولاً انتخاب مطمئنتری است.
آیا لپتاپ گیمینگ برای Local AI کافی است؟
در بیشتر موارد بله. اگر GPU NVIDIA قدرتمند، VRAM کافی، RAM مناسب و خنککنندگی خوب داشته باشد، الزاماً به Workstation گرانقیمت نیاز ندارید.






نظر خود را اضافه کنید.
برای ارسال نظر وارد شوید
ارسال نظر بدون عضویت در سایت